模型概览
- 规模未记录
- 权重未记录
- 量化NVFP4
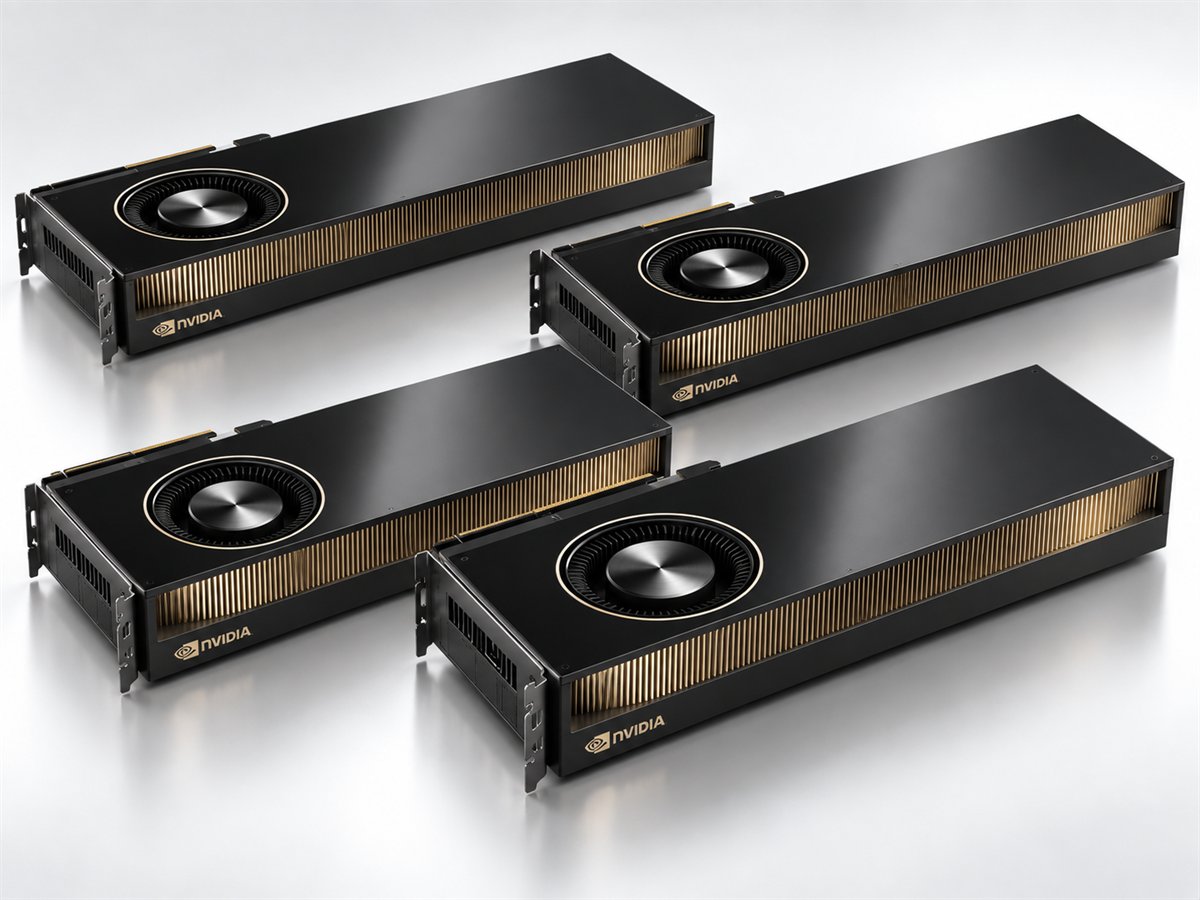
- 单卡显存96 GB(是 RTX 5090 的 3 倍)
- 总显存384 GB
96GB 单卡显存,把长上下文和并发同时拉满。以下数据来自对应测试环境,用于展示这套配置的真实性能边界与适用条件。
意味着瓶颈换了一个:在 5090 上限制你的是显存能装多少上下文,在这台机器上限制你的是 GPU 算力本身 —— 实测跑 10 路 25 万字时,KV 缓存只用了 43%。
单路实测 282 tok/s(三次 277.86 / 278.78 / 290.05),是本次全部配置里单路最快的。
两种极端场景都实测过:64 路短问题(每人 65 字输入、2,048 字输出)输出吞吐 3,245 tok/s、首 token 中位仅 0.14 秒;10 路 25 万字超长上下文全部成功。
| 场景 | 并发 | 请求数 | 单请求输入 / 输出 | 吞吐 | 首 token | 每字间隔 |
|---|---|---|---|---|---|---|
| 短问题高并发 | 64 | 640 | 65 / 2,048 | 3,245.17 tok/s | 140.97 ms | 19.09 ms |
| 超长上下文 | 10 | 10 | 258,048 / 4,096 | ≈1,100 tok/s | 136.46 s | 35.07 ms |
| 单路 | 1 | 3 | — | 282.23 tok/s | — | — |
| 同时工作的 Agent 数 | 总请求 | 总输入 tokens | 平均输出吞吐 | 首 token 中位 | 每字间隔 | 每人感受 |
|---|---|---|---|---|---|---|
| 4 | 20 | 3,659,054 | 87.33 tok/s | 12.59 s | 16.80 ms | 59.5 tok/s |
| 8 | 40 | 7,319,589 | 92.69 tok/s | 18.02 s | 50.84 ms | 19.7 tok/s |
| 10 | 50 | 14,074,941 | 53.34 tok/s | 38.10 s | 100.59 ms | 9.9 tok/s |
根据你的模型、并发与业务场景,获取对应的算力部署建议。