看配置
查看已收录的算力设备配置与实测数据
这里不做推荐排序,也不限定固定档位。收录了哪些真实测试配置,就展示哪些配置;进入详情即可查看该配置部署过的模型与性能数据。
共 8 个配置
2× RTX 5090 32GB
单卡就能跑 27B 级模型并把 12 万字上下文装进显存;加第二张卡可把上下文推到原生 262,144。
4× RTX 5090 32GB
四张消费级卡跑起 125 GiB 的 MoE 大模型,实测支撑 20 路并发、每路仍有 29 tok/s,首 token P95 不到 0.55 秒。
8× RTX 5090 32GB
把八张卡做成两个互不干扰的完整副本,实测 120 路 6 万字上下文请求全部成功,聚合输入吞吐 8,957 tok/s。
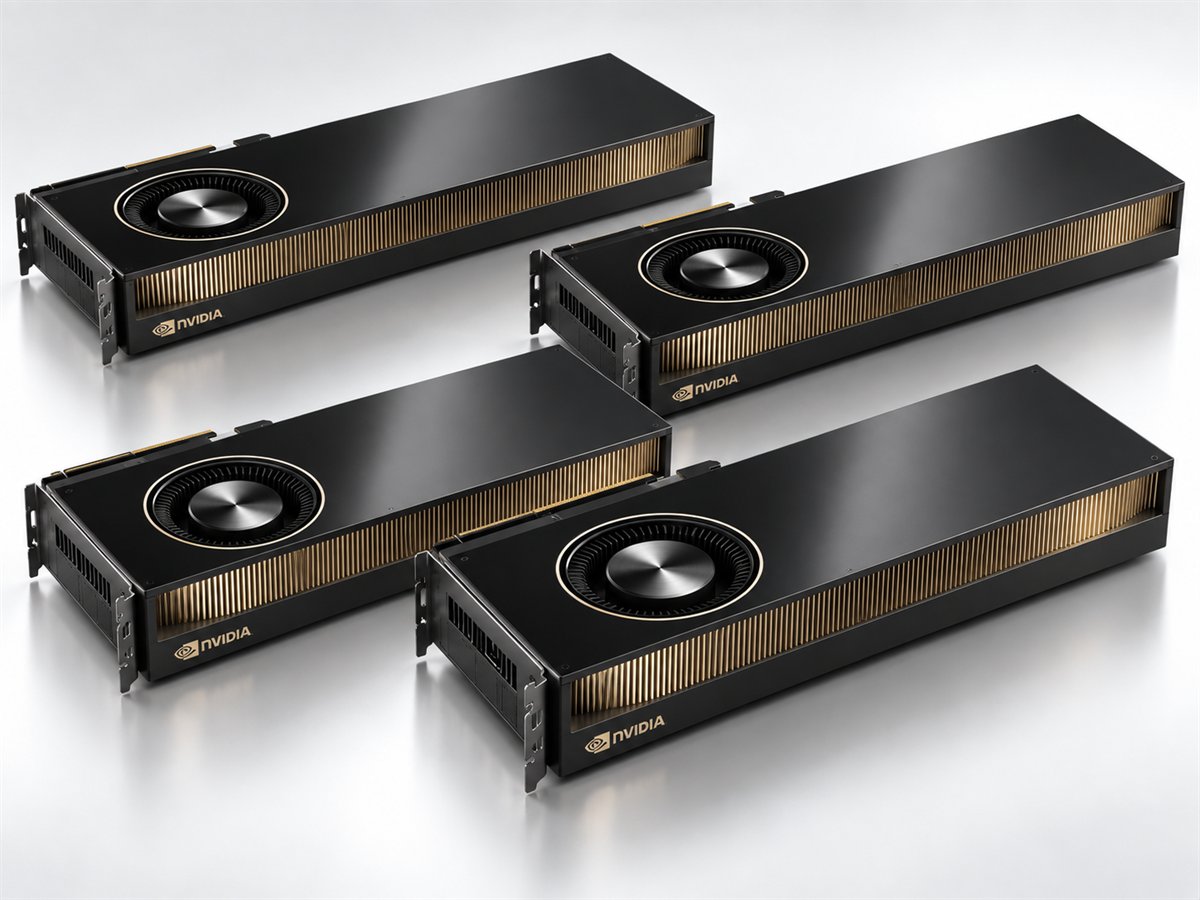
4× RTX PRO 6000 96GB
单卡 96GB、总算力与显存都是消费级的三倍。10 路 25 万字长上下文同时进行全部成功,短问题高并发输出吞吐 3,245 tok/s。
1× RTX 3080 Laptop 16GB
单张 RTX 3080 Laptop 16GB 实测 Qwen3.5-0.8B,在 80 路并发、每路 1000 tokens 输入 / 2000 tokens 输出的负载下,聚合输出吞吐达到 2,314 tok/s。
1× RTX 2080 Ti 22GB
单张 22GB RTX 2080 Ti 实测 Qwen3.5-0.8B,在 128 路并发、每路 500 tokens 输入 / 1000 tokens 输出的负载下,聚合输出吞吐达到 4,264.5 tok/s。
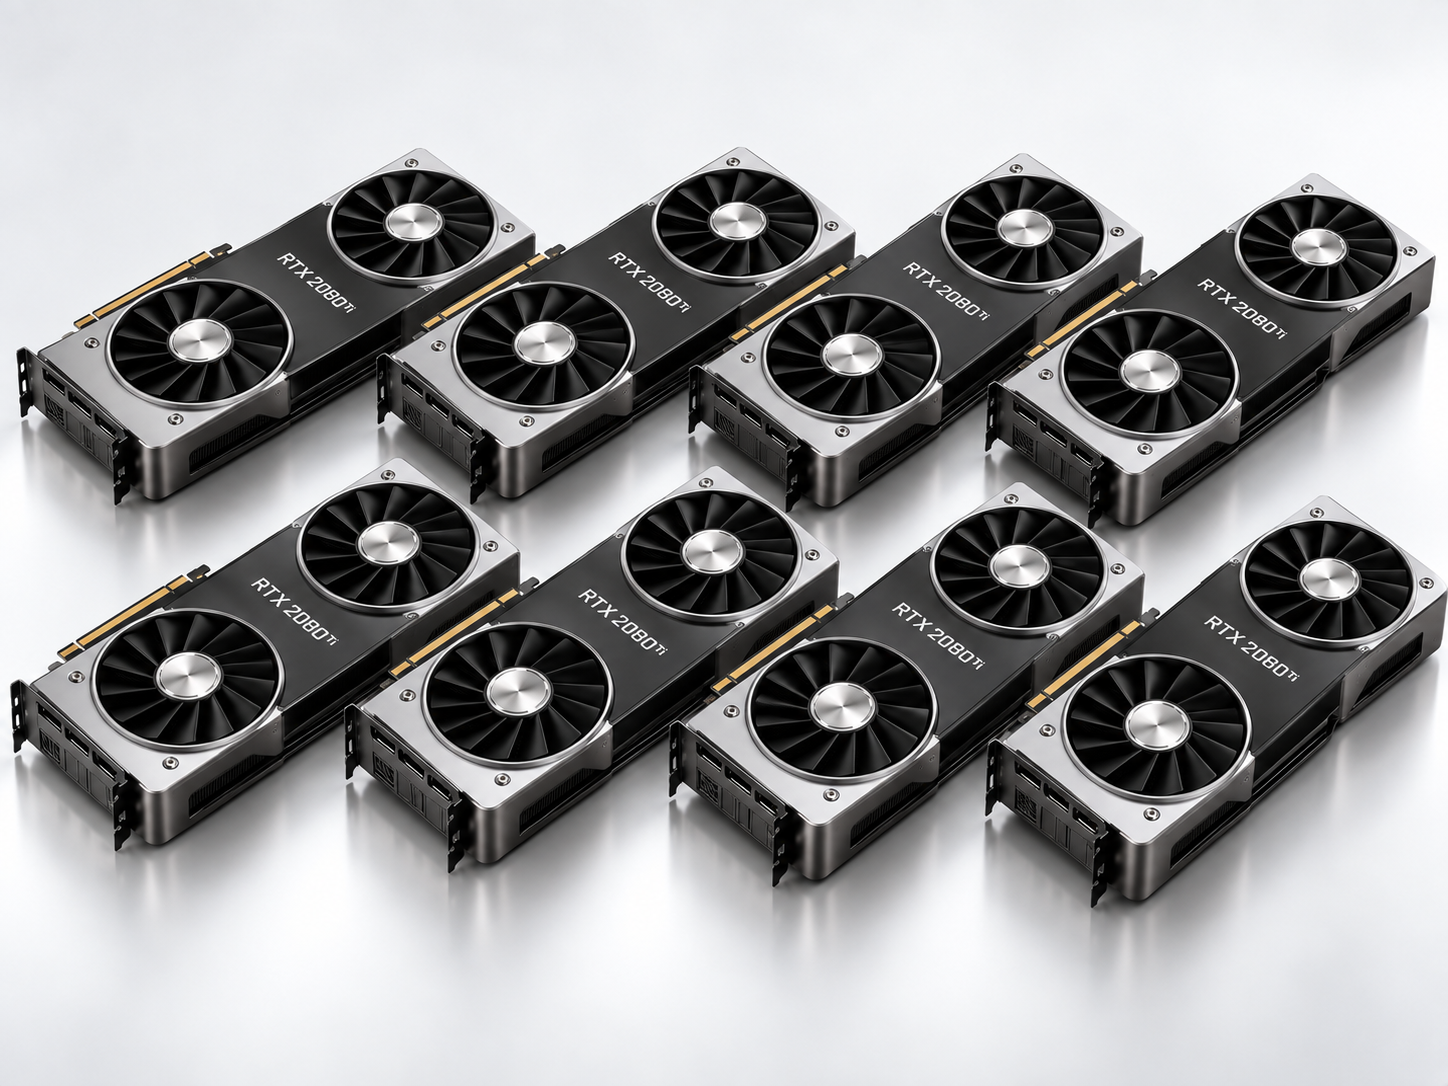
8× RTX 2080 Ti 22GB
8 张 22GB RTX 2080 Ti 组成 176GB 显存池,使用 Qwen3.8-Flash-Next UD-Q4_K_XL GGUF 与 llama.cpp SM75/Qwen4Exp 优化路线,在 128K 上下文档稳定跑通。
1× RTX 3090 Ti 24GB · llamAmpere
来源于 JakeATX/llamAmpere 的公开方案。面向 RTX 3090 / 3090 Ti 的 SM86 专项优化;公开主表数据在 RTX 3090 Ti 350W 上测得,Qwen3.8-27B 可在 24GB 单卡上运行长上下文并使用原生 MTP speculative decoding。