适合场景
- 多人在线推理服务
- Agent / 工具调用
- 代码辅助
- 25 万字长文分析
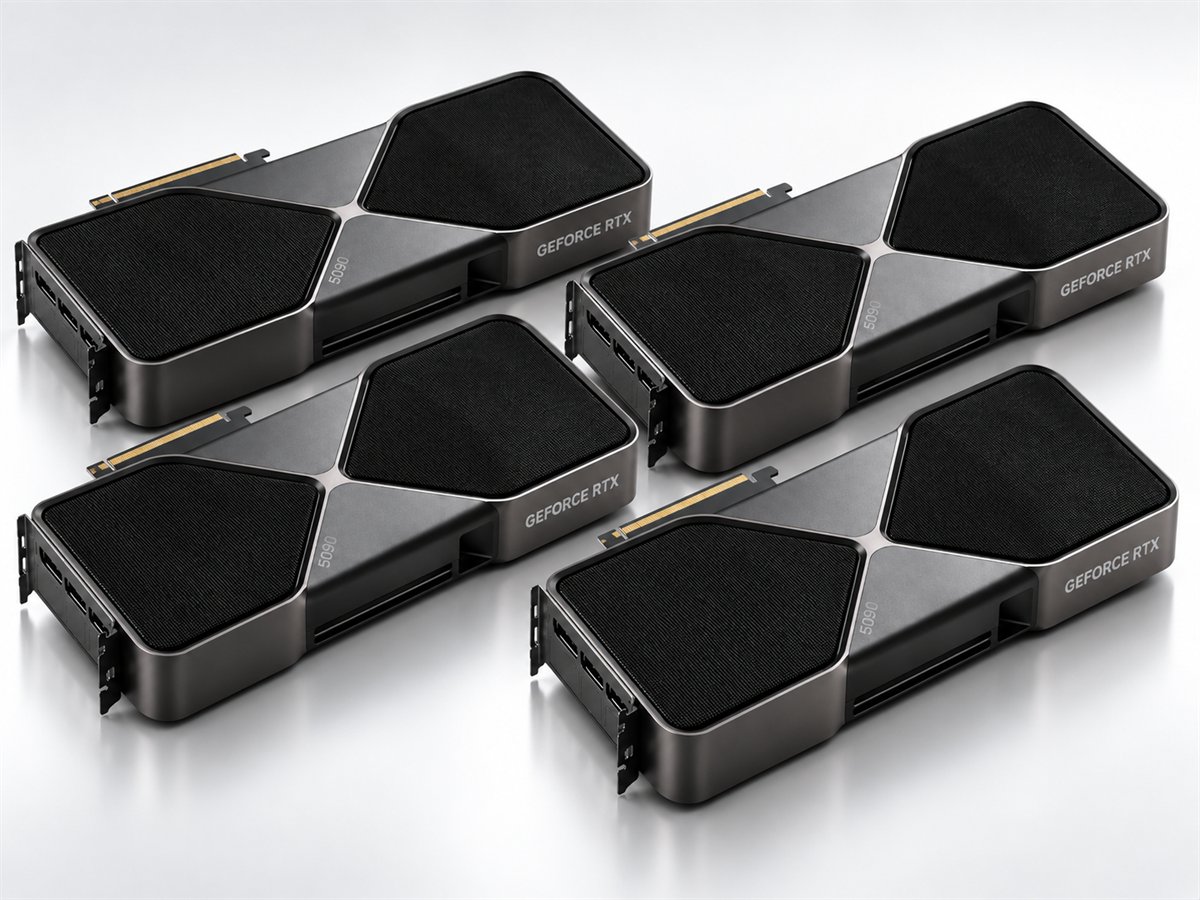
四张消费级卡跑起 125 GiB 的 MoE 大模型,实测支撑 20 路并发、每路仍有 29 tok/s,首 token P95 不到 0.55 秒。
以下模型已在这套硬件上完成实测,点击进入查看完整数据。
125 GiB 级 MoE 大模型,四张消费级卡跑起来
这台机器的最佳区间是10–20 人同时在线:总计 580–604 tok/s,每人 29–40 tok/s,首 token 半秒左右。20 人以上建议上 8 卡。
同样四张卡,换成小模型 → 长上下文吞吐提升到 6 倍
如果你需要的是长文档批处理和高并发,同样四张卡换成 27B 能拿到 6 倍的吞吐;如果需要1.8 万字以上的一次性长读和更强的通用能力,用 Flash-Next。
对比不同卡数和显存规模,找到更贴近业务目标的方案。