企业级 AI 硬件入门方案博原方案

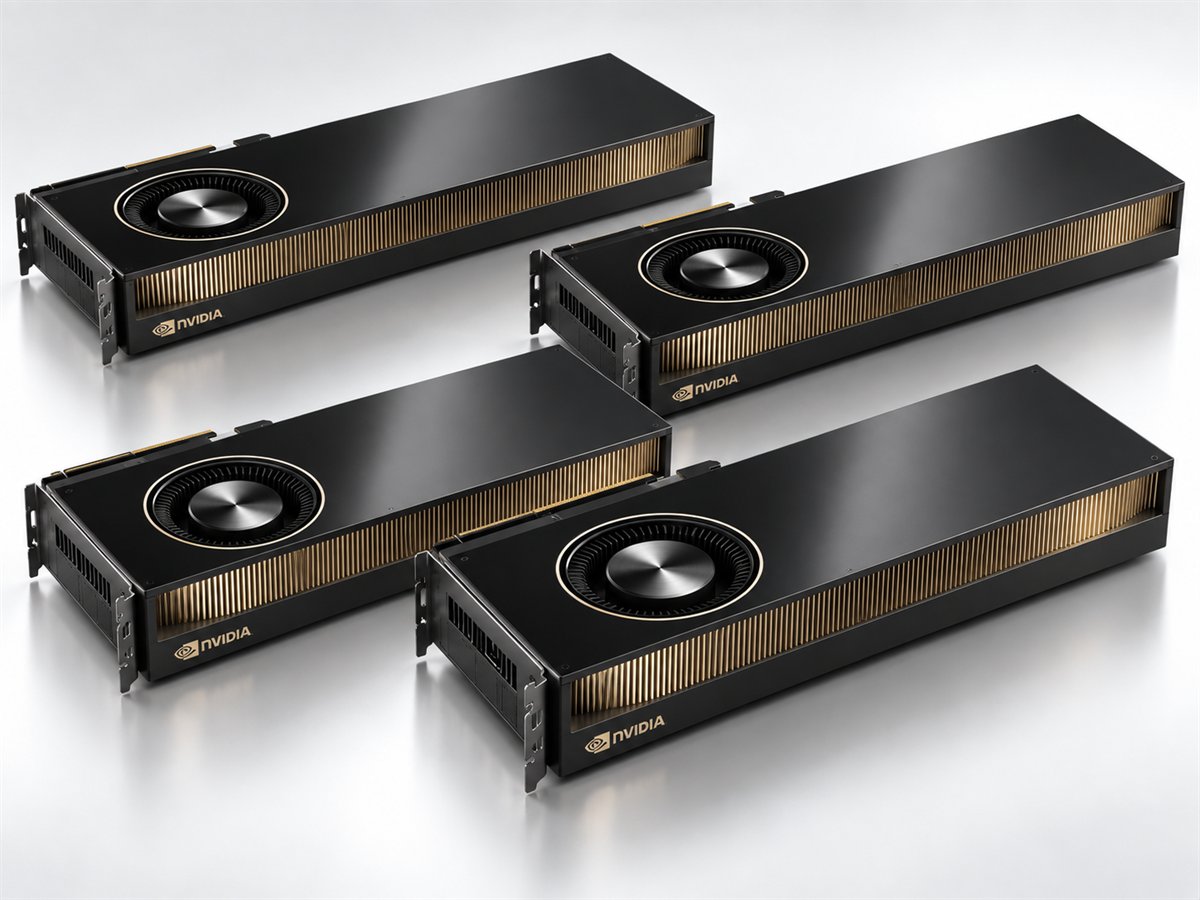
2× RTX 5090 32GB

入门档:一张卡解决 12 万字,两张卡顶到 26 万字

单卡就能跑 27B 级模型并把 12 万字上下文装进显存;加第二张卡可把上下文推到原生 262,144。

2 卡64 GB 总显存Blackwell sm120原生长上下文

适合场景

  • 长文档批处理
  • 单卡私有化部署
  • 对成本敏感的第一台机器

实测模型

  • Qwen3.8-27B
  • 32 GB 单卡显存

选型限制

  • 超长上下文下不适合 50 路以上并发
  • 26 万字上下文需要双卡 TP=2
  • 跨卡通信会牺牲单路速度

推荐理由

  • 适合主流模型推理,一台双卡机即可支撑长文档批处理与多路并发任务。
  • 可查看对应模型的吞吐、并发与上下文实测结果

选择模型

以下模型已在这套硬件上完成实测,点击进入查看完整数据。

查看全部模型

Qwen3.8-27B-NVFP4

dense 27B + 原生视觉,一张卡就装得下

查看完整实测
核心实测结果
1,633 tok/s聚合输入吞吐
未测聚合输出吞吐
157 tok/s单路输出
19 路6 万字最大并发
833,295KV 池
1.70 s最低首 token
适用任务
长文档理解与批处理多轮长上下文问答图片 + 文本混合输入

入门档:一张卡解决 12 万字,两张卡顶到 26 万字

其他配置推荐

对比不同卡数和显存规模,找到更贴近业务目标的方案。