我们实测出的能力
基于真实机器环境的实测数据,以下是部分关键能力指标
数据持续更新最近更新:2026-09-27
5~60 人
同时服务
中小型企业按人数选档:两卡 5 路 → 四卡 60 路
256K
上下文 · 一次读完 25 万字
原生 262,144 上下文;实测 25 万字材料一次读进去
0.135 s
最低首 Token
256 字短问答单路实测最低;长文命中前缀缓存后 1.1–1.2 s
290.05 tok/s
极致调优的单路输出
4× PRO 6000 三次单路实测最高,三次均值约 282 tok/s
916.6 tok/s
20 路聚合输出
四卡机 256 字短问答 × 20 路实测,0 失败 0 溢出
0 失败
7×24 连续运行
现网已连续跑 146.6 分钟 / 651 个请求:0 中断 · 0 报错 · 0 显存溢出
热门配置方案
我们已实测多种配置,满足不同规模和场景的需求
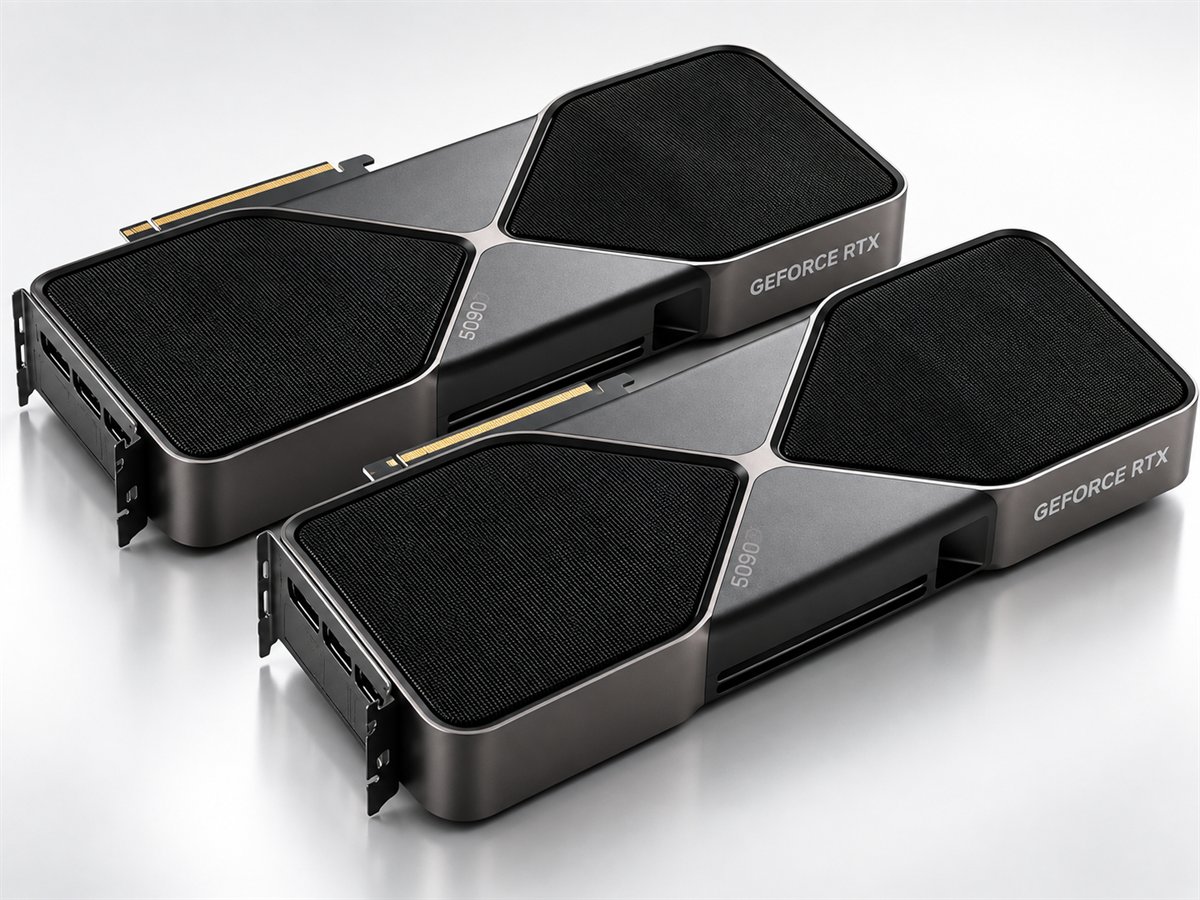
2× RTX 5090 32GB
适合主流模型推理,一台双卡机即可支撑长文档批处理与多路并发任务。
查看详情
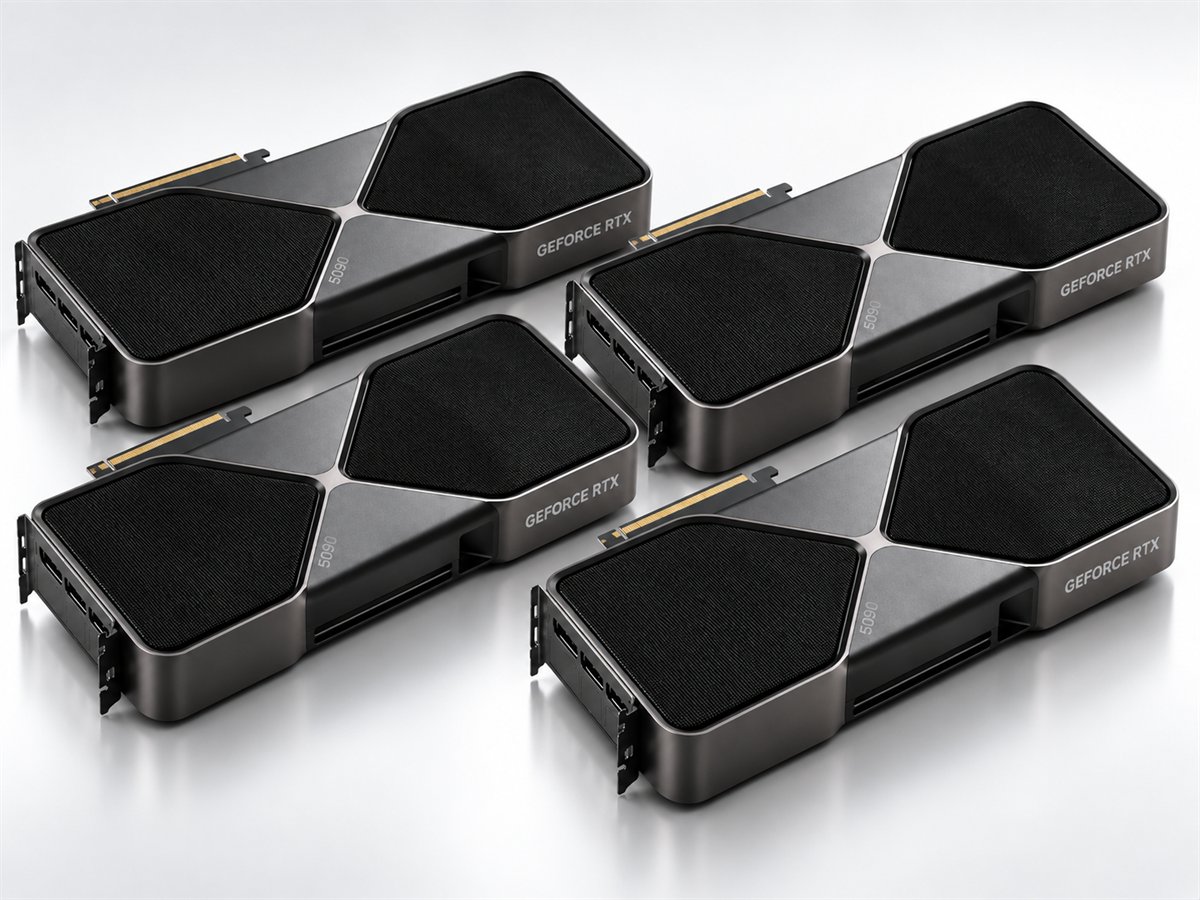
4× RTX 5090 32GB
适合高并发任务与多用户场景:20 人同时在线,每人仍有 29 tok/s,性价比最高的一档。
查看详情
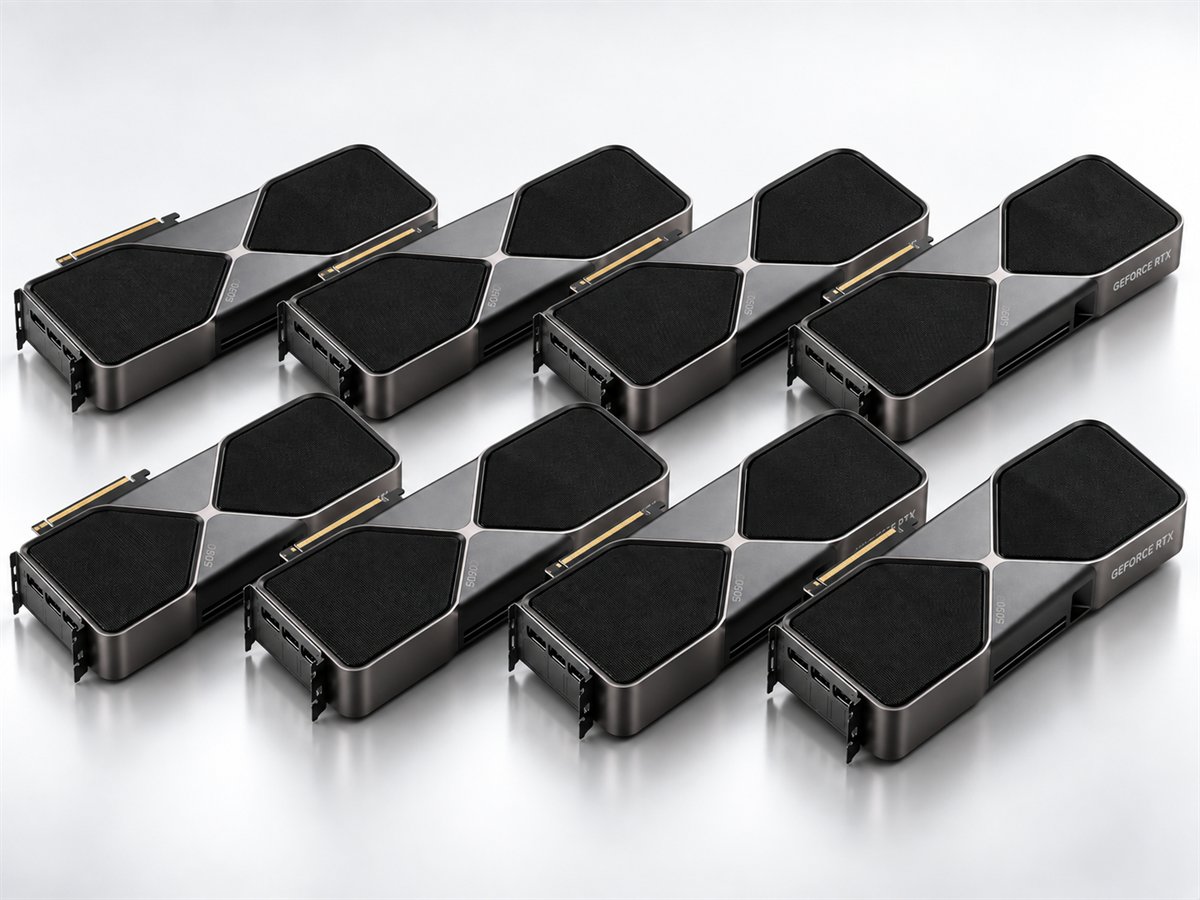
8× RTX 5090 32GB
适合百人级在线场景:6 万字上下文 120 路并发全部成功,整机功耗仅 1.68 kW。
查看详情
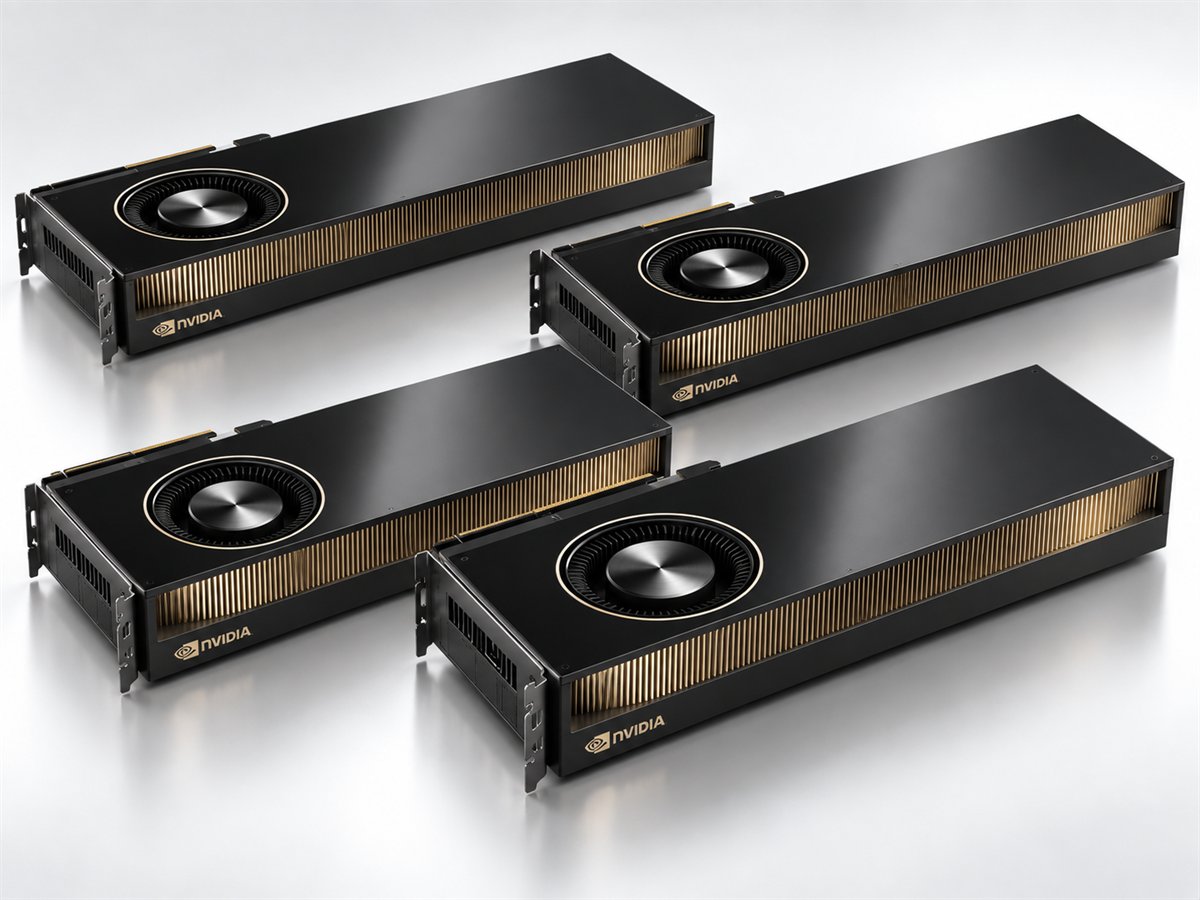
4× RTX PRO 6000 96GB
适合大模型与高并发兼顾的场景:单卡 96GB,10 路 × 25 万字长上下文同时进行。
查看详情
1× RTX 3080 Laptop 16GB
16GB 单卡运行 Qwen3.5-0.8B,80 路并发实测总吞吐 3,284 tok/s。
查看详情
1× RTX 2080 Ti 22GB
22GB 单卡运行 Qwen3.5-0.8B,128 路并发实测总吞吐 6,448 tok/s。
查看详情
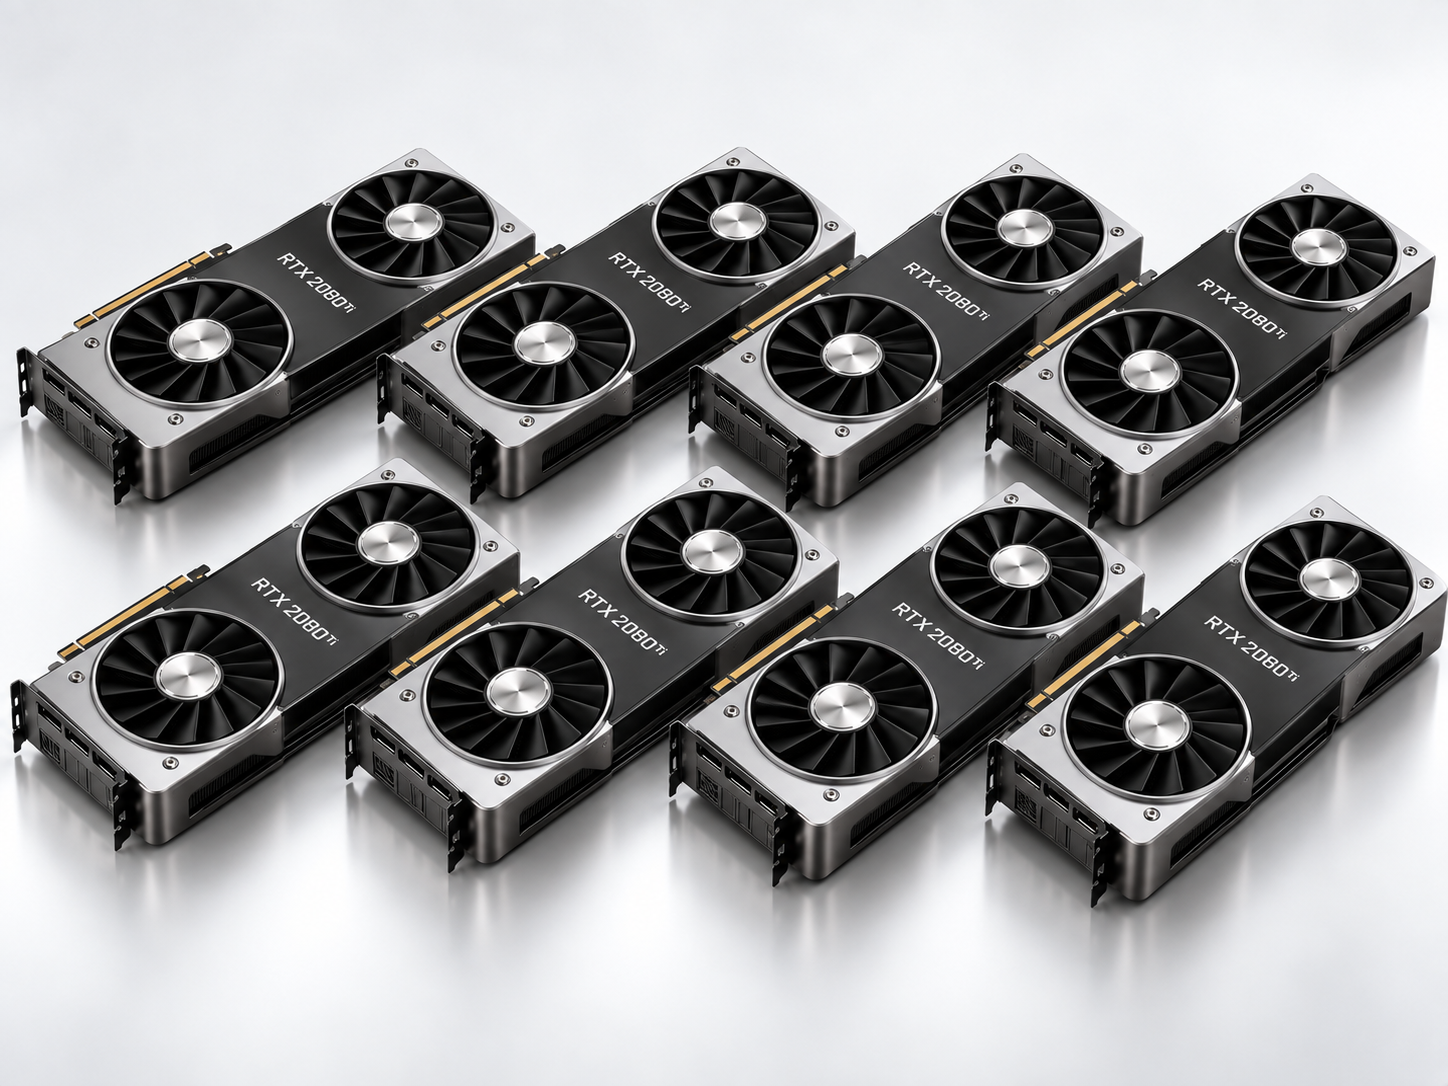
8× RTX 2080 Ti 22GB
176GB 总显存复用老卡集群,Flash-Next Q4 稳定单路约 37 tok/s,4K prefill 约 545 tok/s。
查看详情
1× RTX 3090 Ti 24GB · llamAmpere
JakeATX/llamAmpere v0.3.1:RTX 3090 Ti 24GB 上的 Qwen3.8-27B SM86 优化路线,公开成绩最高约 99 tok/s,支持 200K+ 上下文。
查看详情
能力案例
精选 6 个现场生成的真实产物 —— 网页、游戏、工具都可以直接打开体验
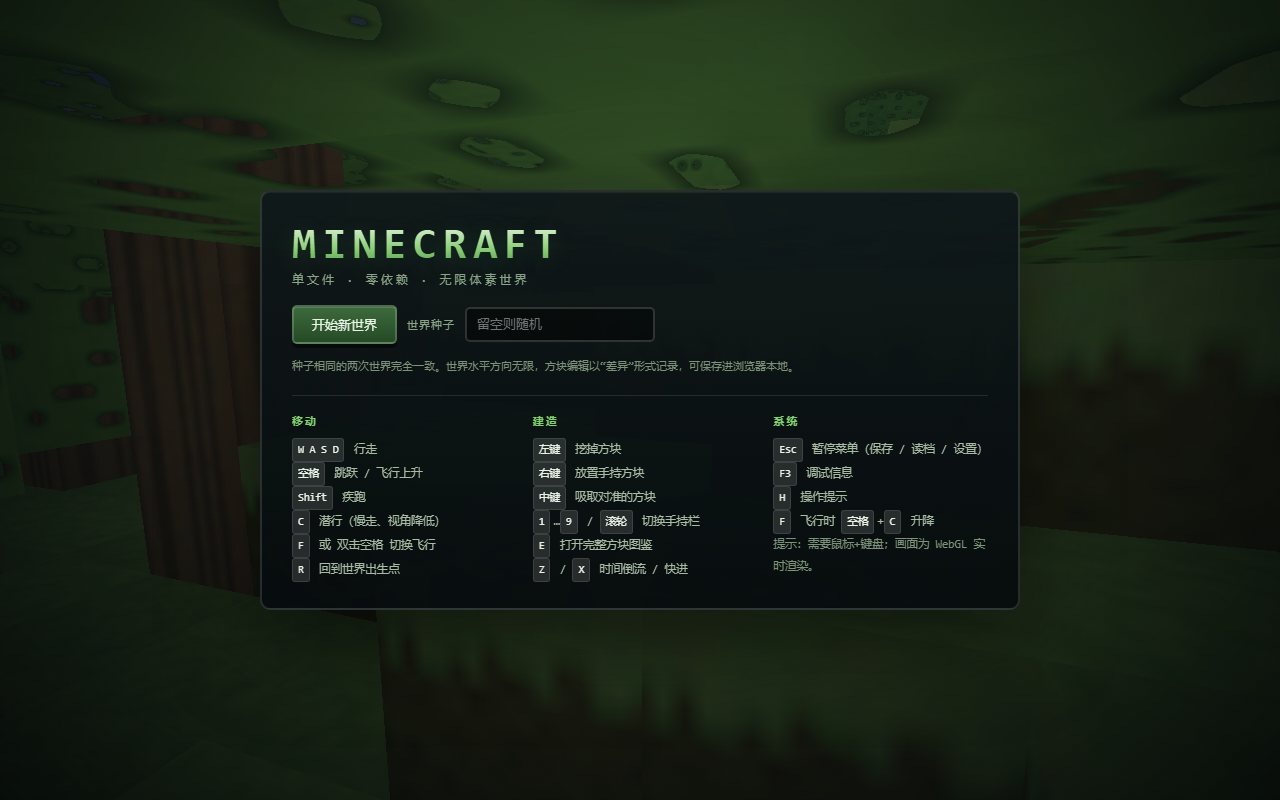 产物可玩
3D 体素沙盒:打开就能挖方块
两个模型同题各生一版,Flash-Next 版自带本地存档
Qwen3.8-Flash-Next
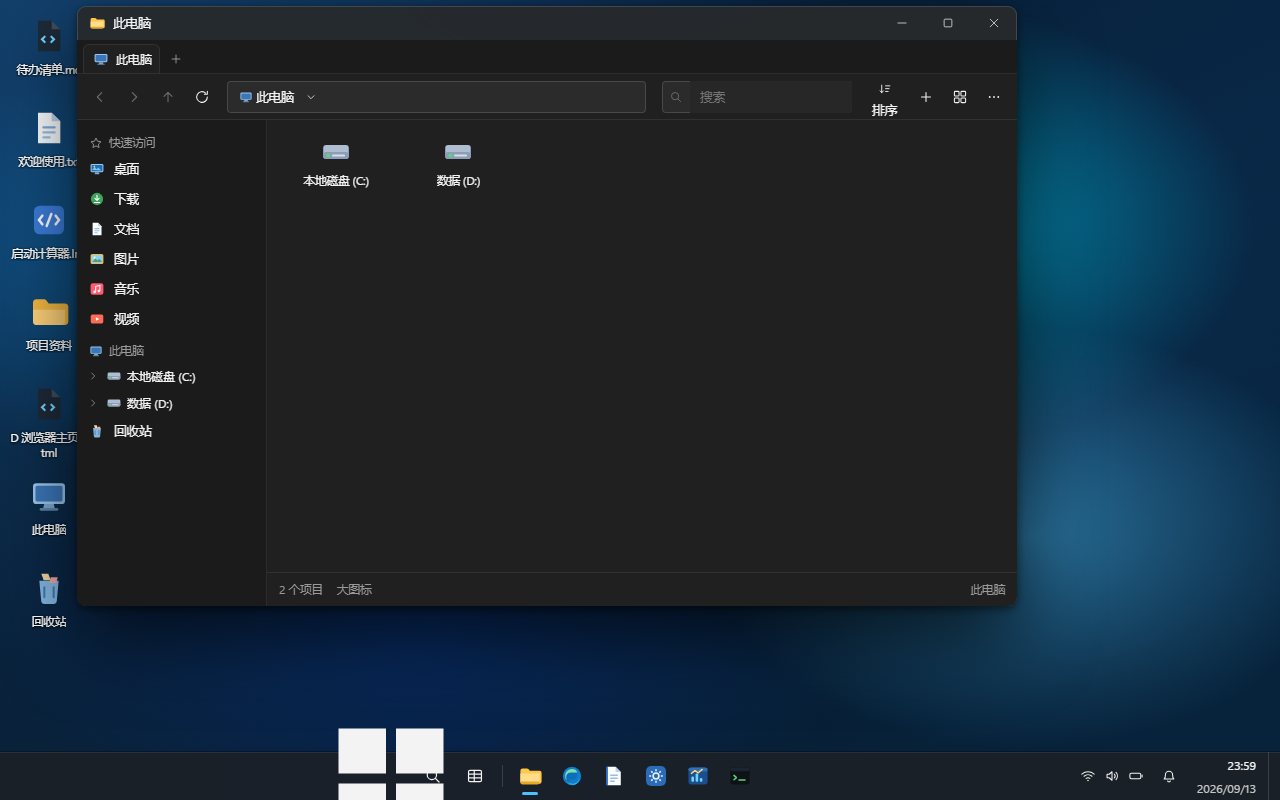 产物可玩
Windows 11 桌面模拟器:窗口、任务栏、开始菜单
拖动 / 缩放 / 多开、虚拟文件系统、一组内置系统应用,全在一个文件里
Qwen3.8-Flash-Next
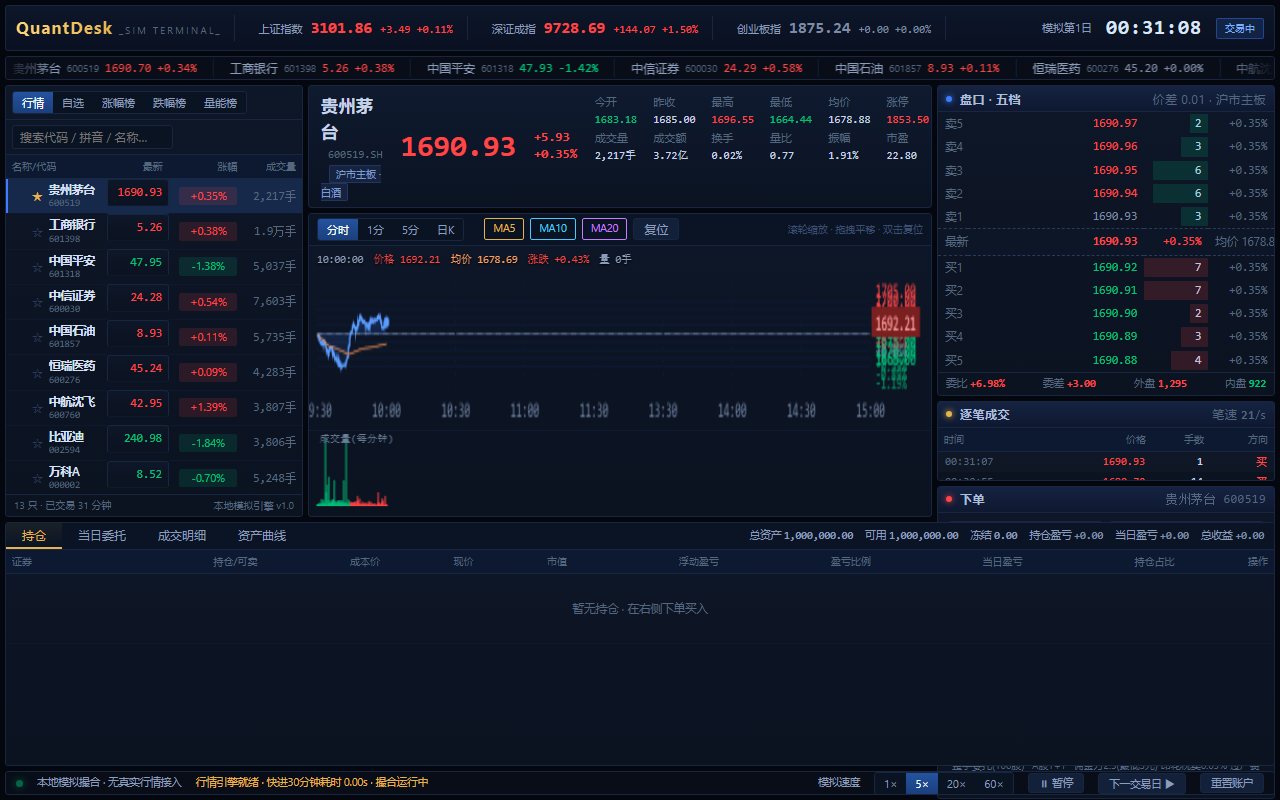 产物可玩
仿真证券交易终端:行情、下单、持仓、T+1 全齐
带 K 线、手续费、当日委托与资产曲线的完整交易台
Qwen3.8-Flash-Next
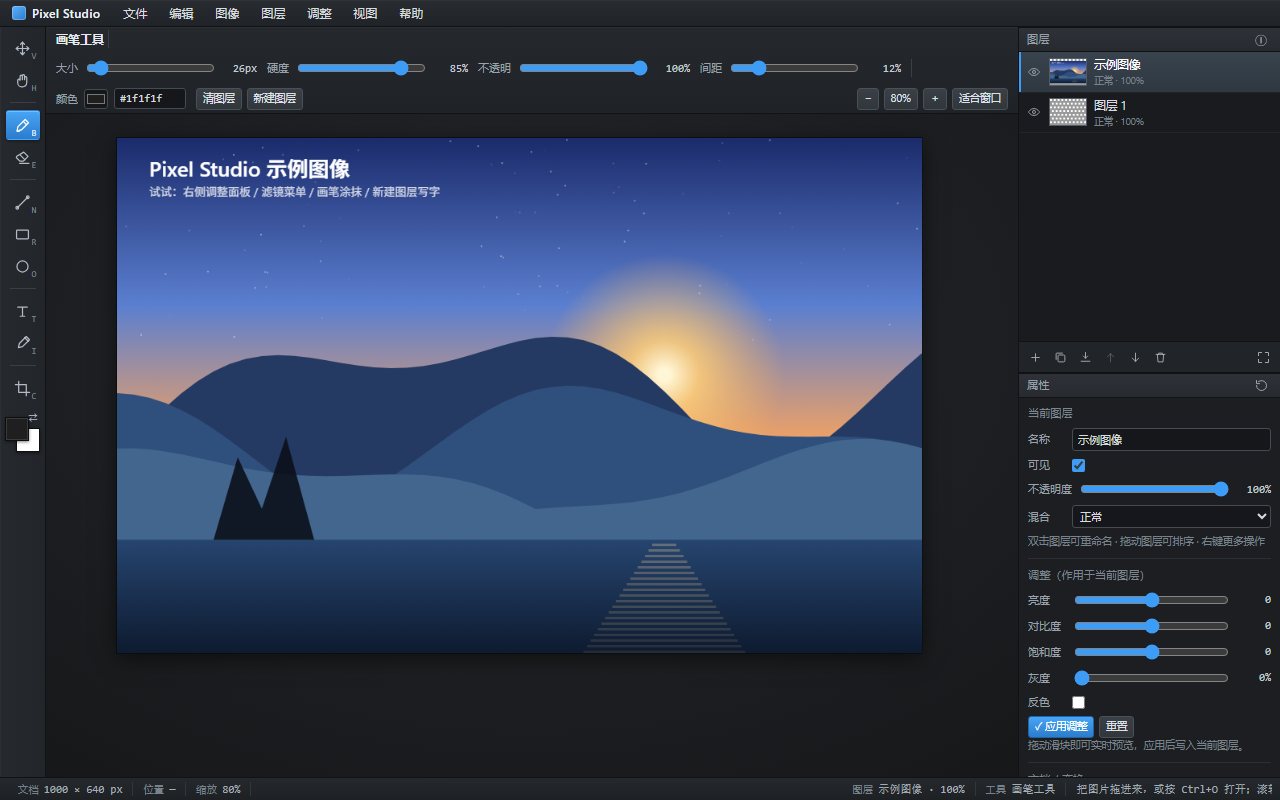 产物可玩
网页版简易 Photoshop:图层、画笔、滤镜
含图层混合、调整面板、快捷键体系的图像编辑器
Qwen3.8-Flash-Next
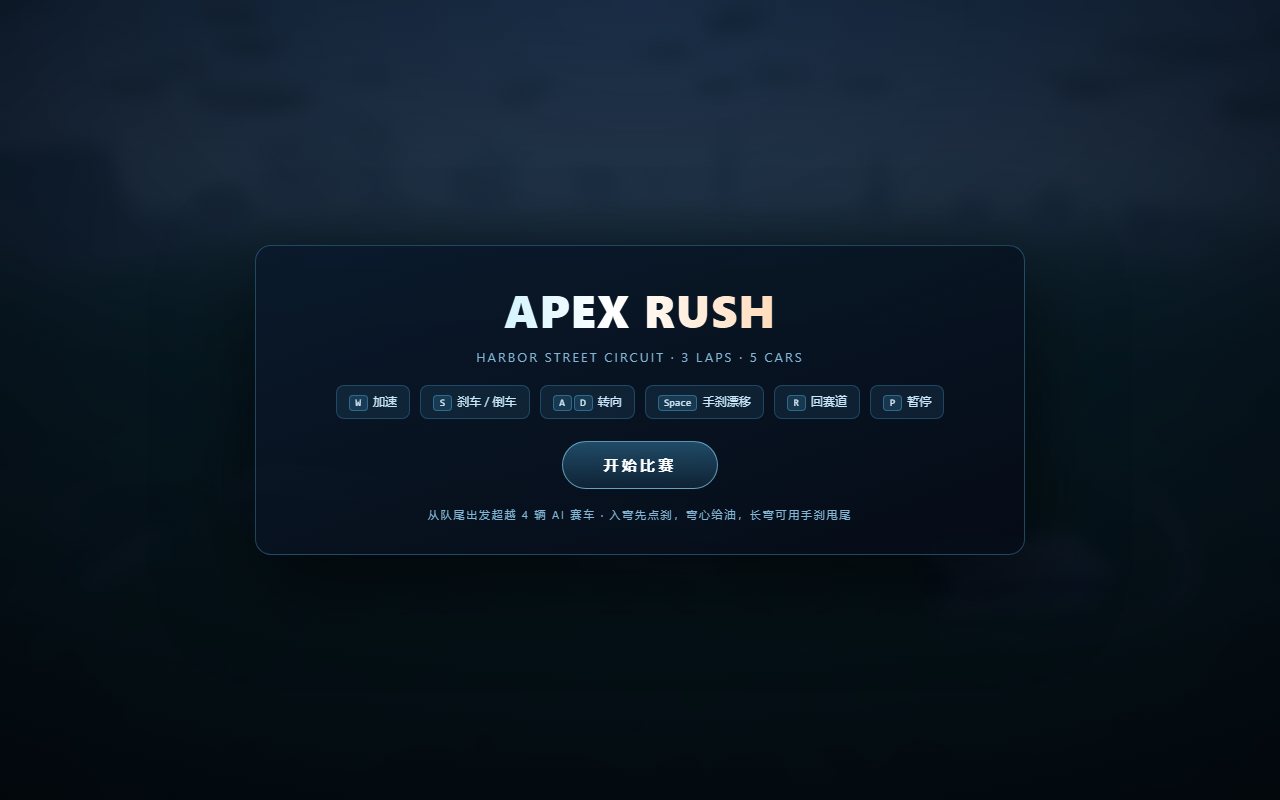 产物可玩
3D 赛车:一条赛道直接从提示词里跑出来
两个模型同题各生一版,浏览器里直接开赛
Qwen3.8-Flash-Next
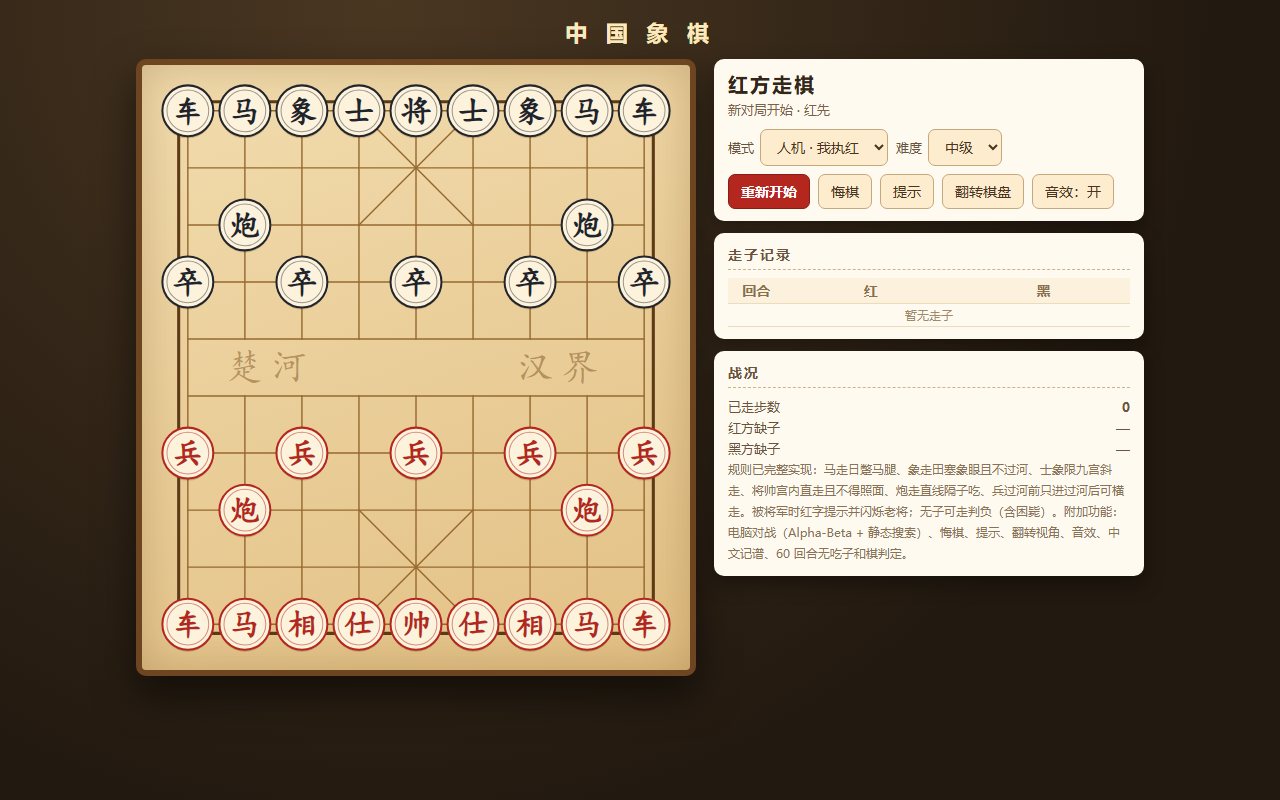 产物可玩
中国象棋:人机对弈、双人同屏都能下
单文件 31 KB 的完整棋局,人机可对战
Qwen3.8-Flash-Next