GPU 推理实测方案博原方案

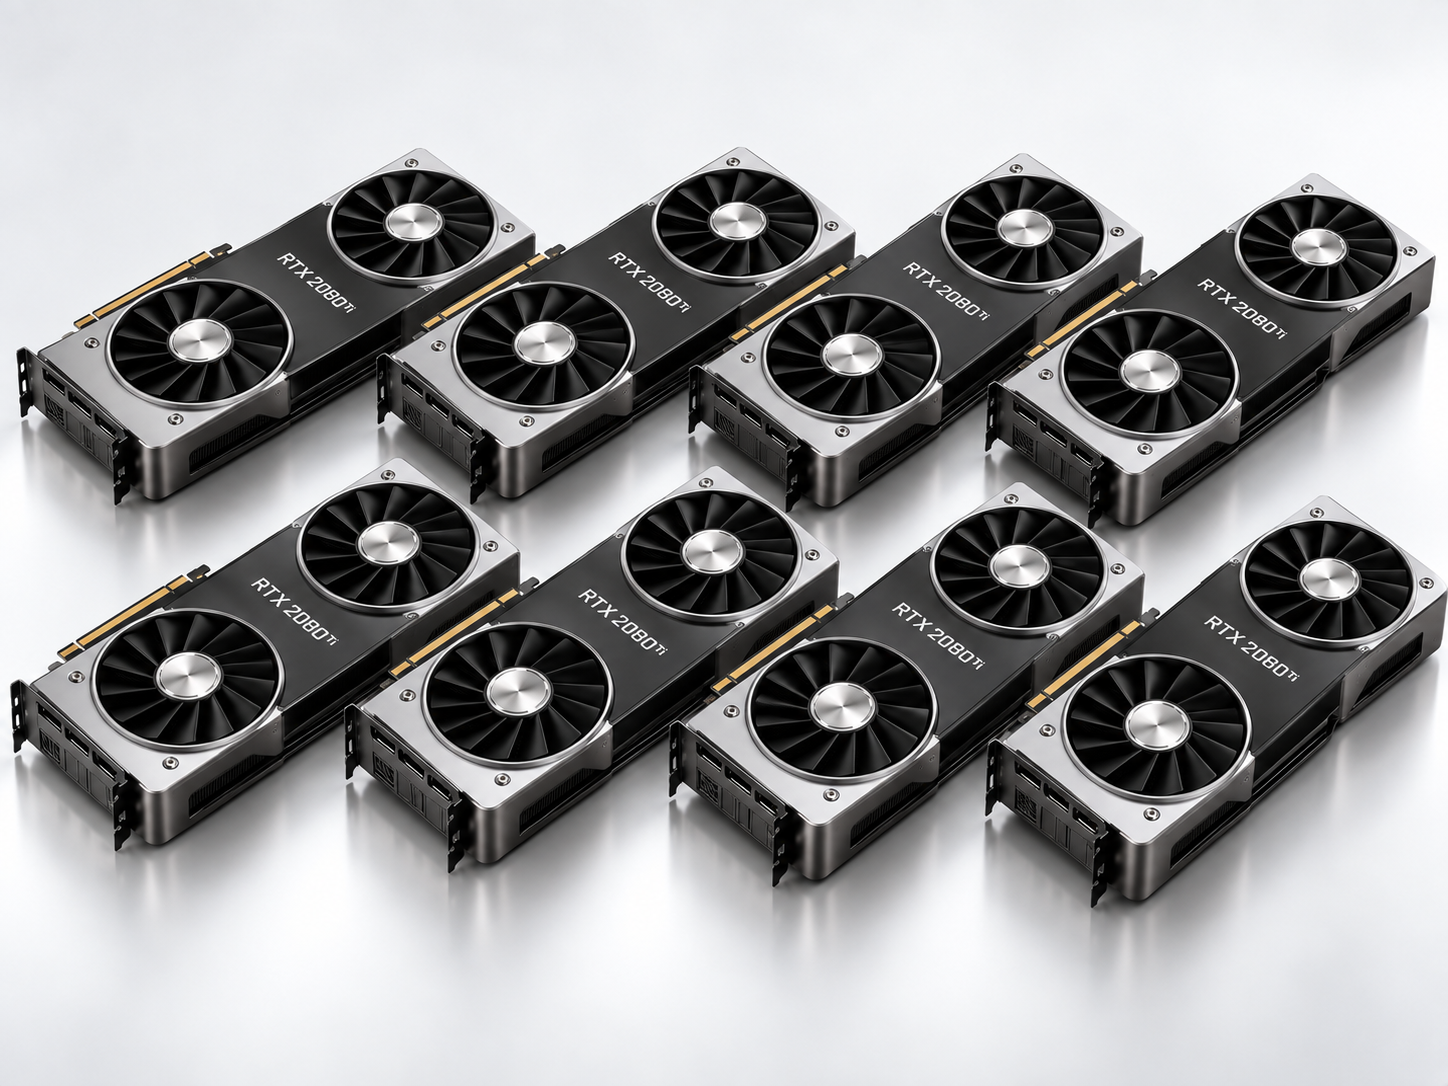
8× RTX 2080 Ti 22GB

存量老卡复用:Flash-Next Q4 稳定 37 tok/s,128K 上下文

8 张 22GB RTX 2080 Ti 组成 176GB 显存池,使用 Qwen3.8-Flash-Next UD-Q4_K_XL GGUF 与 llama.cpp SM75/Qwen4Exp 优化路线,在 128K 上下文档稳定跑通。

8 卡176 GB 总显存Turing sm75原生长上下文

适合场景

  • 存量 2080 Ti 算力复用
  • Qwen3.8-Flash-Next 私有化推理
  • 128K 长上下文单路服务
  • 预算敏感的旧卡集群改造

实测模型

  • Qwen3.8-Flash-Next-UD-Q4_K_XL
  • 22 GB 单卡显存

选型限制

  • 请结合上下文长度和并发目标选型

推荐理由

  • 176GB 总显存复用老卡集群,Flash-Next Q4 稳定单路约 37 tok/s,4K prefill 约 545 tok/s。
  • 可查看对应模型的吞吐、并发与上下文实测结果

选择模型

以下模型已在这套硬件上完成实测,点击进入查看完整数据。

查看全部模型

Qwen3.8-Flash-Next-UD-Q4_K_XL

8×22GB Turing 老卡集群跑通 Flash-Next Q4,稳定单路约 37 tok/s

查看完整实测
核心实测结果
37.04 tok/s稳定 Decode
544.77 tok/s4K Prompt Prefill
≈0.37 s最佳 TTFT
128K运行上下文
适用任务
存量老卡算力复用128K 长上下文问答私有化单路推理服务

这套方案的价值不是和 5090 拼峰值,而是把已有的 8×2080 Ti 22GB 资产继续用起来:在 128K 上下文下稳定跑 Qwen3.8-Flash-Next Q4,单路约 37 tok/s,适合预算敏感的旧卡集群改造与私有化推理。

其他配置推荐

对比不同卡数和显存规模,找到更贴近业务目标的方案。