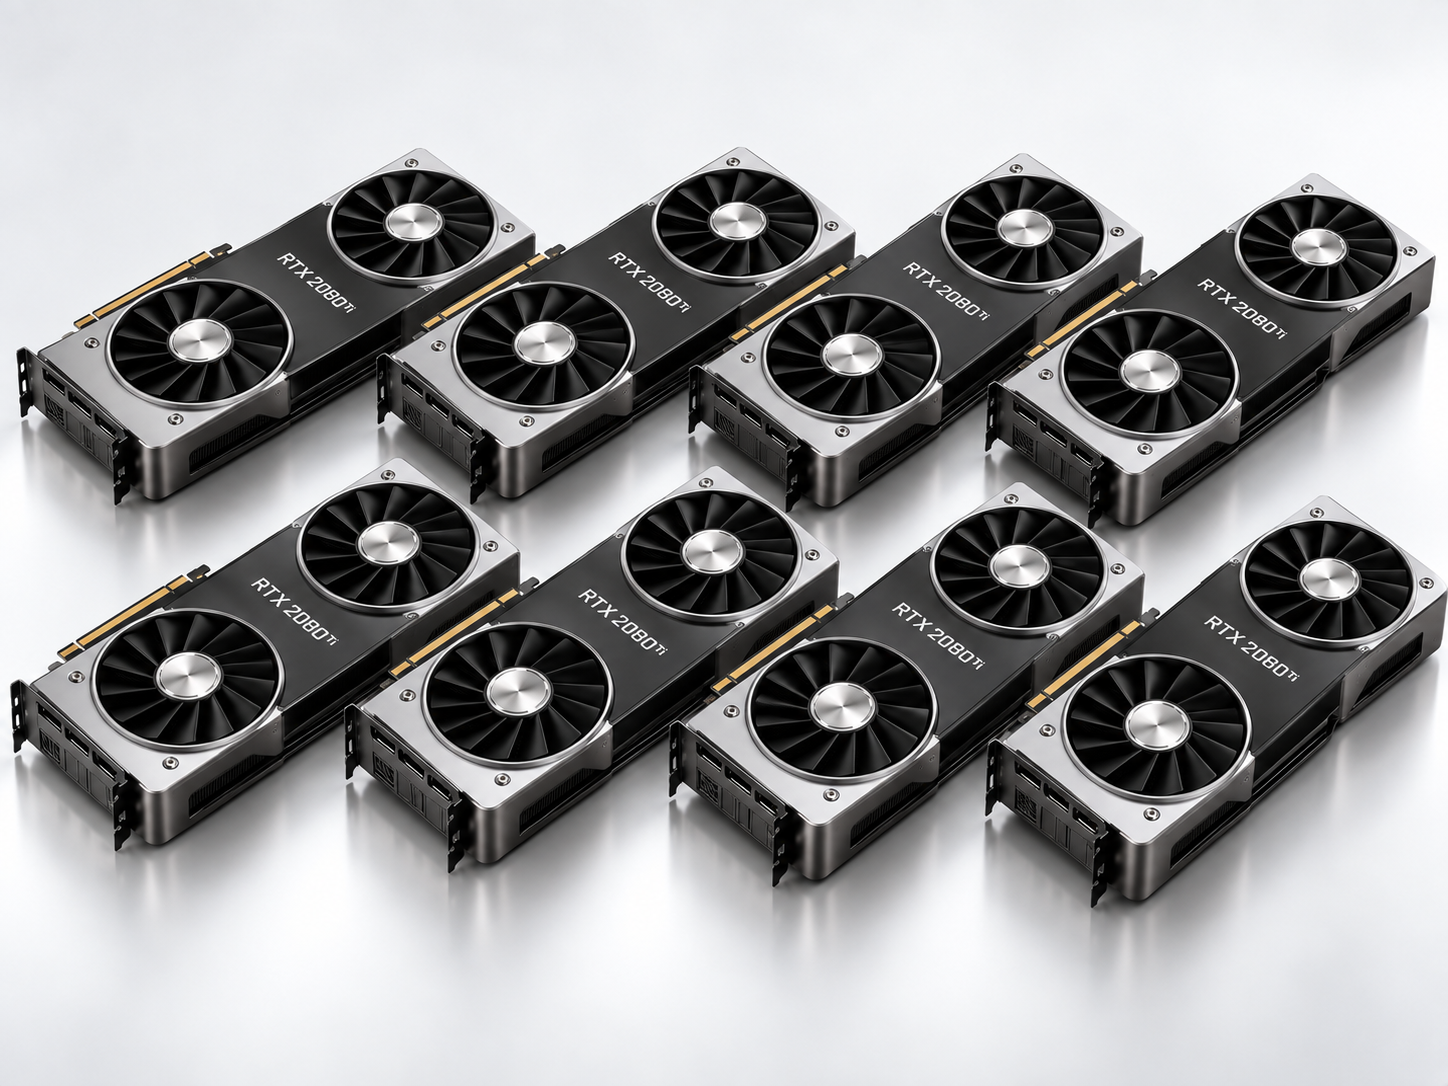
8× RTX 2080 Ti 22GB · Qwen3.8-Flash-Next-UD-Q4_K_XL

实测结果

8×22GB Turing 老卡集群跑通 Flash-Next Q4,稳定单路约 37 tok/s。以下数据来自对应测试环境,用于展示这套配置的真实性能边界与适用条件。

经过博原人工智能调优后的实测数据
8× RTX 2080 Ti 22GB176 GB 总显存规模:Qwen3.8-Flash-Next主模型量化:UD-Q4_K_XL GGUF推理框架:llama.cpp · SM75/Qwen4Exp 优化 fork
37.04 tok/s稳定 Decodev4 long 4K;short 36.92 / mid 37.01
544.77 tok/s4K Prompt Prefillv4 稳定版实测
≈0.37 s最佳 TTFT稳定版最优实测
128K运行上下文131,072 tokens;Q8_0 K / Q8_0 V

模型概览

  • 规模Qwen3.8-Flash-Next
  • 主模型量化UD-Q4_K_XL GGUF
  • 推理框架llama.cpp · SM75/Qwen4Exp 优化 fork
  • 运行上下文131,072 tokens(128K)
  • KV CacheQ8_0 K / Q8_0 V

适合做什么

  • 存量老卡算力复用
  • 128K 长上下文问答
  • 私有化单路推理服务

使用时要注意

  • 博原本机 v4 稳定基线。主模型为 UD-Q4_K_XL GGUF;Q8_0 K/V;128K context;MTP OFF。未记录可核验的最终 KV pool token 数,因此不做推测。
  • 主模型约 90GB 级别后,仍需为 Q8 KV、workspace 与 CUDA buffer 留出显存;PLE 主要放 CPU/RAM,避免挤占 GPU 显存。
  • 这一组成绩是当前已确认的稳定基线;后续 MTP sidecar 的实验结果不混入本页。
  • llama.cpp 这版没有留下类似 vLLM 的最终 KV pool token 打印数值,因此只公开已确认的 128K Q8 KV 运行事实,不反推一个假 KV pool。

选型结论

这套方案的价值不是和 5090 拼峰值,而是把已有的 8×2080 Ti 22GB 资产继续用起来:在 128K 上下文下稳定跑 Qwen3.8-Flash-Next Q4,单路约 37 tok/s,适合预算敏感的旧卡集群改造与私有化推理。
获取企业部署建议
数据口径说明博原本机 v4 稳定基线。主模型为 UD-Q4_K_XL GGUF;Q8_0 K/V;128K context;MTP OFF。未记录可核验的最终 KV pool token 数,因此不做推测。
单卡

八张 2080 Ti 能不能跑 Flash-Next?

可以。主模型采用 UD-Q4_K_XL GGUF,8×22GB 共 176GB 显存;PLE / n-gram 查找表主要放在 CPU 内存,GPU 侧承担 Q4 主模型、QSA 计算、Q8 KV 与 CUDA workspace,在 128K 档稳定跑通。

176 GB
总显存
8 × 22GB RTX 2080 Ti
128K
稳定运行上下文
131,072 tokens
Q8_0
KV Cache
K / V 均使用 Q8_0
项目公开口径说明
GPU8× RTX 2080 Ti 22GBTuring sm75
主模型UD-Q4_K_XL GGUF不是 NVFP4
推理框架llama.cpp SM75/Qwen4Exp 优化 fork针对老架构做专项优化
多卡方式Layer Split八卡均参与主模型分层
MTP未计入稳定成绩v4 基线为 MTP OFF
客户站只展示可验证的部署口径与实测结果;完整启动命令、内部环境变量和调优细节不公开。
主模型约 90GB 级别后,仍需为 Q8 KV、workspace 与 CUDA buffer 留出显存;PLE 主要放 CPU/RAM,避免挤占 GPU 显存。
单路

单路性能能到多少?

稳定 v4 基线下,Decode 已从最初约 32 tok/s 提升到 36.8~37.0 tok/s;4K Prompt Prefill 从约 87 tok/s 提升到 544.77 tok/s,TTFT 最优约 0.37 秒。

36.8~37.0
稳定 Decode(tok/s)
三档输入长度均稳定在 37 左右
544.77
4K Prefill(tok/s)
相较初版约 6.2×
≈0.37 s
最佳 TTFT
初版约 0.6 s
测试Decode TGPrefill PP说明
short36.92 tok/s—短输入基线
mid37.01 tok/s—中等输入基线
long 4K37.04 tok/s544.77 tok/s稳定版长输入实测
v4 的三档 Decode 基本收敛在 37 tok/s,说明稳定性已经明显好于初版。
指标初版稳定 v4变化
Decode31.8~32 tok/s36.8~37.0 tok/s约 +15%
Prefill约 87 tok/s536~545 tok/s约 6.2×
TTFT约 0.6 s约 0.37 s明显下降
这一组成绩是当前已确认的稳定基线;后续 MTP sidecar 的实验结果不混入本页。
多路

多并发成绩怎么算?

这版 v4 benchmark 主要用于 np=1 单路性能基线,当时没有形成可作为正式口径发布的 1 / 2 / 4 / 8 路完整并发矩阵,因此本页不虚构并发数据。

1 路
稳定基线口径
v4 benchmark 主要为单路 np=1
未发布
多并发正式成绩
后续需单独按统一口径复测
MTP OFF
本次稳定成绩
sidecar MTP 后续单独验证
llama.cpp 这版没有留下类似 vLLM 的最终 KV pool token 打印数值,因此只公开已确认的 128K Q8 KV 运行事实,不反推一个假 KV pool。