模型概览
- 规模dense 27B + 原生 VLM
- 权重23.44 GB(NVFP4 量化)
- 上下文262,144 tokens 原生支持
- 结构64 层 = 48 层线性注意力(GDN)+ 16 层全注意力
- KV 池双卡 833,295 tokens(3.18× @262K)
dense 27B + 原生视觉,一张卡就装得下。以下数据来自对应测试环境,用于展示这套配置的真实性能边界与适用条件。
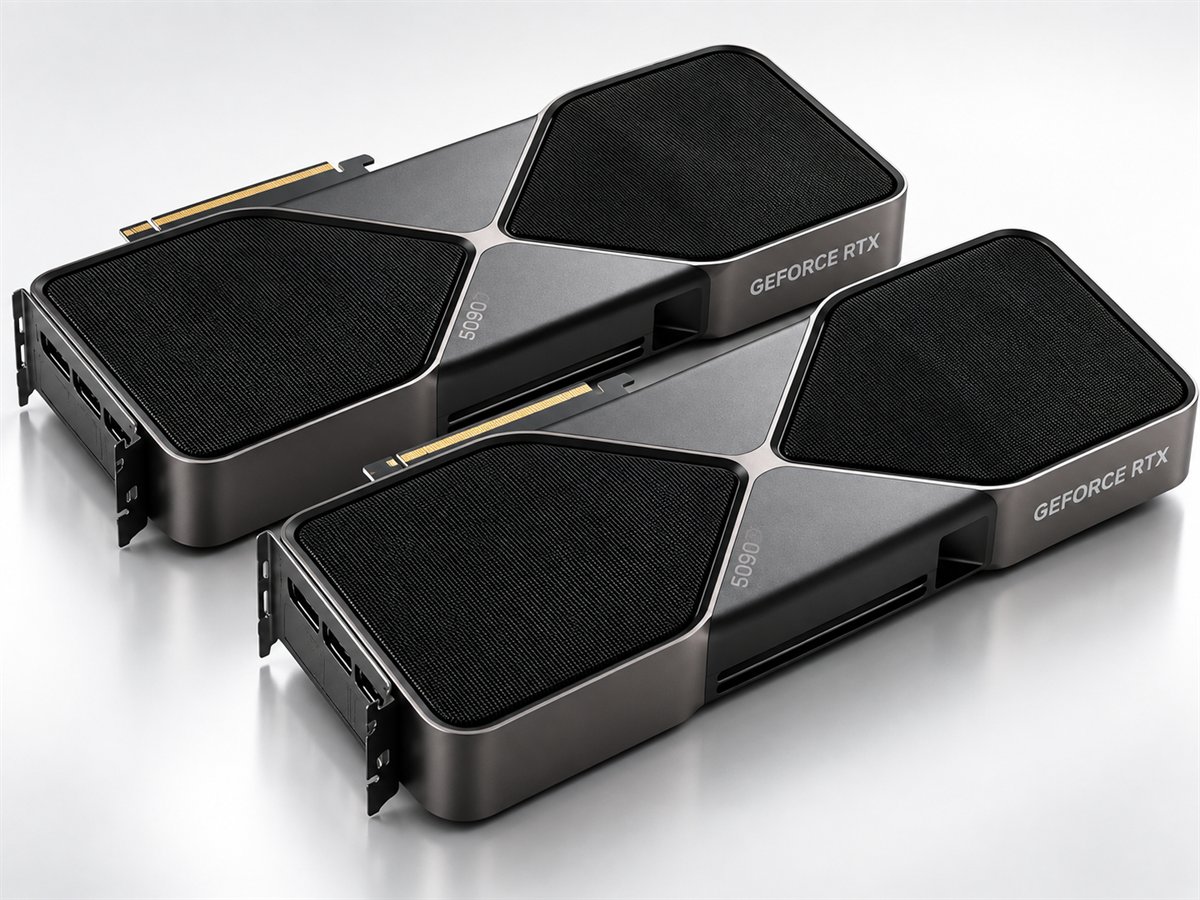
够。27B 量化后只有 23.44 GB,一张 32GB 的 5090 就能完整装下权重加 KV。而且单卡反而比双卡快 3.5 倍 —— 双卡要跨卡通信,单卡完全不需要。
| 方案 | 卡数 | 聚合 prefill(tok/s) | 单请求上下文 | 说明 |
|---|---|---|---|---|
| 单卡 TP=1 | 1 | 6,534 | ≈ 120K | 零跨卡通信,速度最快 |
| 2 副本(2× TP=1) | 2 | 12,891 | ≈ 120K/副本 | 线性扩展,2.02× |
| 4 副本(4× TP=1) | 4 | 26,049 | ≈ 120K/副本 | 线性扩展,4.0× |
| 双卡 TP=2 | 2 | 1,723 | 262,144 | 要超长上下文才需要;代价是通信开销 |
要分两种用法看:一次性读完一整篇长文档是"等它读完"的批处理体验;围绕同一份材料反复追问时,缓存会命中,首 token 只要 2 秒,就是正常的对话体验。
| 用法 | 每轮要重新读的 token | 首 token 实测 | 体验 |
|---|---|---|---|
| 多轮追问(12 万字材料) | 约 1,900 | 3.16 / 2.41 s | ✅ 完全可交互 |
| 多轮追问(6 万字材料) | 约 1,900 | p50 ≈ 2.0 s | ✅ 完全可交互 |
| 同一问题纯重复 | 1,900 | 1.76 s(四轮一致) | ✅ 下限 |
| 冷启动读全新 6 万字 | 60,000 | ≈ 37 s | ⚠️ 适合离线批处理 |
| 冷启动读全新 25 万字 | 250,000 | ≈ 195 s | ⚠️ 适合离线批处理 |
6 万字上下文的场景下,19 路是这台机器的天花板;再多加并发不会变快,只会让每个人多等 —— 因为引擎一次只能真正跑 2–3 个请求,其余都在排队。
| 上下文 | 并发 | 成功 / 总数 | 聚合输入 tok/s | 首 token p50 |
|---|---|---|---|---|
| 60K | 5 | 5/5 | 1,630 | 184 s |
| 60K | 10 | 10/10 | 1,633 | 303 s |
| 60K | 20 | 19/20 | 1,575 | 441 s |
| 60K | 40 | 19/40 | 1,570 | 440 s |
| 60K | 60 | 19/60 | 1,567 | 287 s |
| 120K | 10 | 9/10 | 1,490 | 340 s |
| 200K | 5 | 5/5 | 1,400 | 313 s |
| 250K | 5 | 4/5 | 1,107 | 417 s |
根据你的模型、并发与业务场景,获取对应的算力部署建议。