模型概览
- 规模dense 27B + 原生 VLM
- 权重23.44 GB(NVFP4 量化)
- 上下文262,144(数据并行方案下);约 120,000(单卡副本方案下)
- KV 池单卡副本 121,333 tokens;四副本合计 485,332
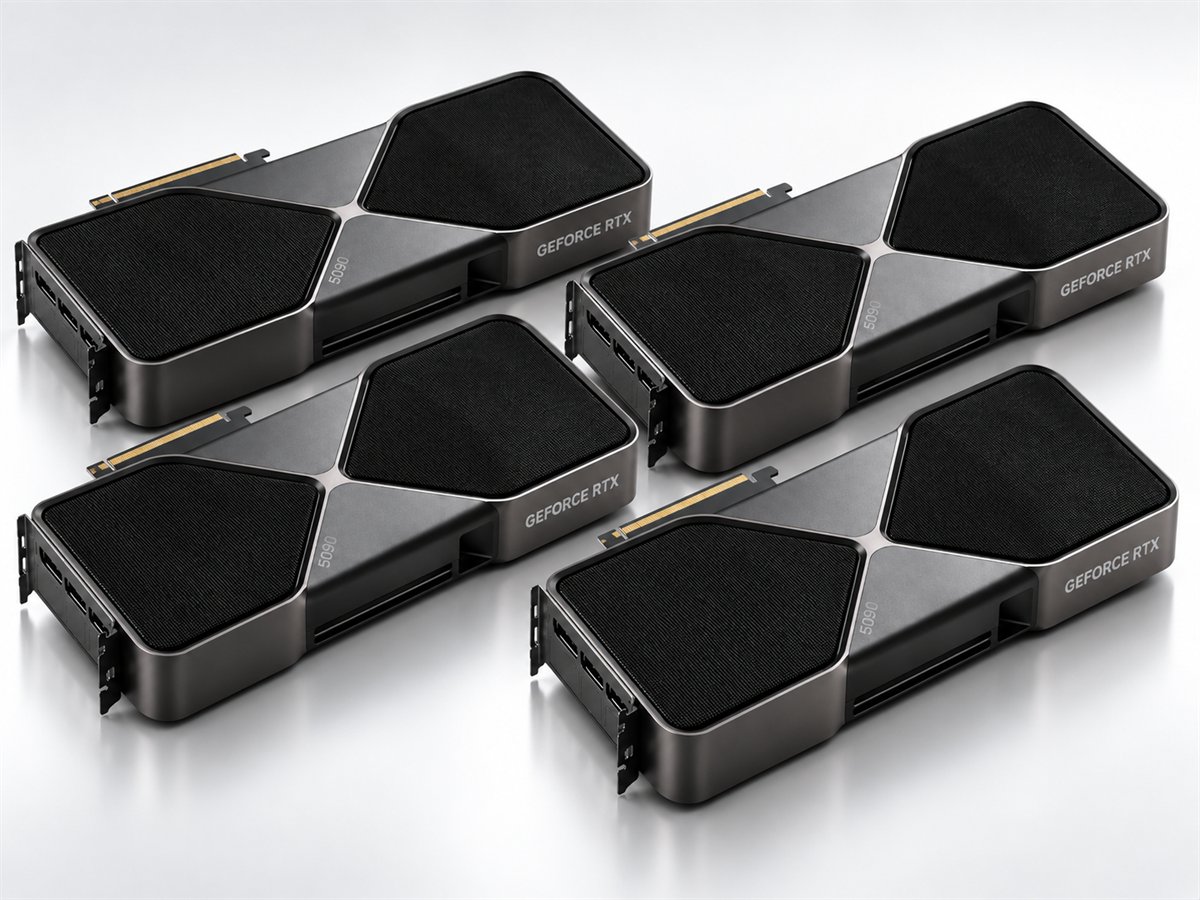
同样四张卡,换成小模型 → 长上下文吞吐提升到 6 倍。以下数据来自对应测试环境,用于展示这套配置的真实性能边界与适用条件。
把四张卡做成四个独立副本(每张卡一个完整模型)而不是拼成一张大卡:实测聚合 26,049 tok/s,是数据并行方案的 6.2 倍,而且四个实例互不干扰(最快与最慢只差 5%)。
| 方案 | 卡数 | 聚合 prefill(tok/s) | 单请求上下文 | 建议 |
|---|---|---|---|---|
| 4× 单卡副本 | 4 | 26,049 | ≈ 120K | ✅ ≤12 万字场景的首选 |
| 2× 数据并行 × 双卡张量并行 | 4 | 4,220 | 262,144 | ✅ 需要超长上下文时选它 |
| 单卡 | 1 | 6,534 | ≈ 120K | 单卡基线 |
| 4 卡张量并行 | 4 | — | 262,144 | ❌ 跨卡通信开销吃掉收益 |
约 1.8 万字的输入,2.7 秒出第一个字;围绕同一份材料反复追问时首 token 约 2 秒。
数据并行方案下,6 万字上下文 60 路并发全部成功,聚合输入 4,224 tok/s —— 是单实例方案的 2.6 倍,首 token 快了 3.2 倍。
| 上下文 | 并发 | 成功 / 总数 | 聚合输入 tok/s | 首 token p50 |
|---|---|---|---|---|
| 60K | 5 | 5/5 | 3,181 | 57 s |
| 60K | 10 | 10/10 | 4,211 | 106 s |
| 60K | 20 | 20/20 | 4,214 | 140 s |
| 60K | 40 | 40/40 | 4,221 | 306 s |
| 60K | 60 | 60/60 | 4,224 | 442 s |
| 120K | 20 | 20/20 | 3,861 | 390 s |
| 120K | 60 | 28/60 | 3,707 | 521 s |
| 200K | 10 | 10/10 | 3,433 | 257 s |
| 250K | 10 | 8/10 | 2,765 | 333 s |
根据你的模型、并发与业务场景,获取对应的算力部署建议。
在相同硬件条件下,对比其他已完成实测的模型。