模型概览
- 规模MoE · 512 专家(每次激活 10 个)
- 权重125.87 GiB(NVFP4 量化)
- 上下文262,144 tokens 原生支持
- 结构48 层 = 12 层全注意力 + 36 层线性注意力
- KV 池531,372 tokens(关闭投机解码后 682,759)
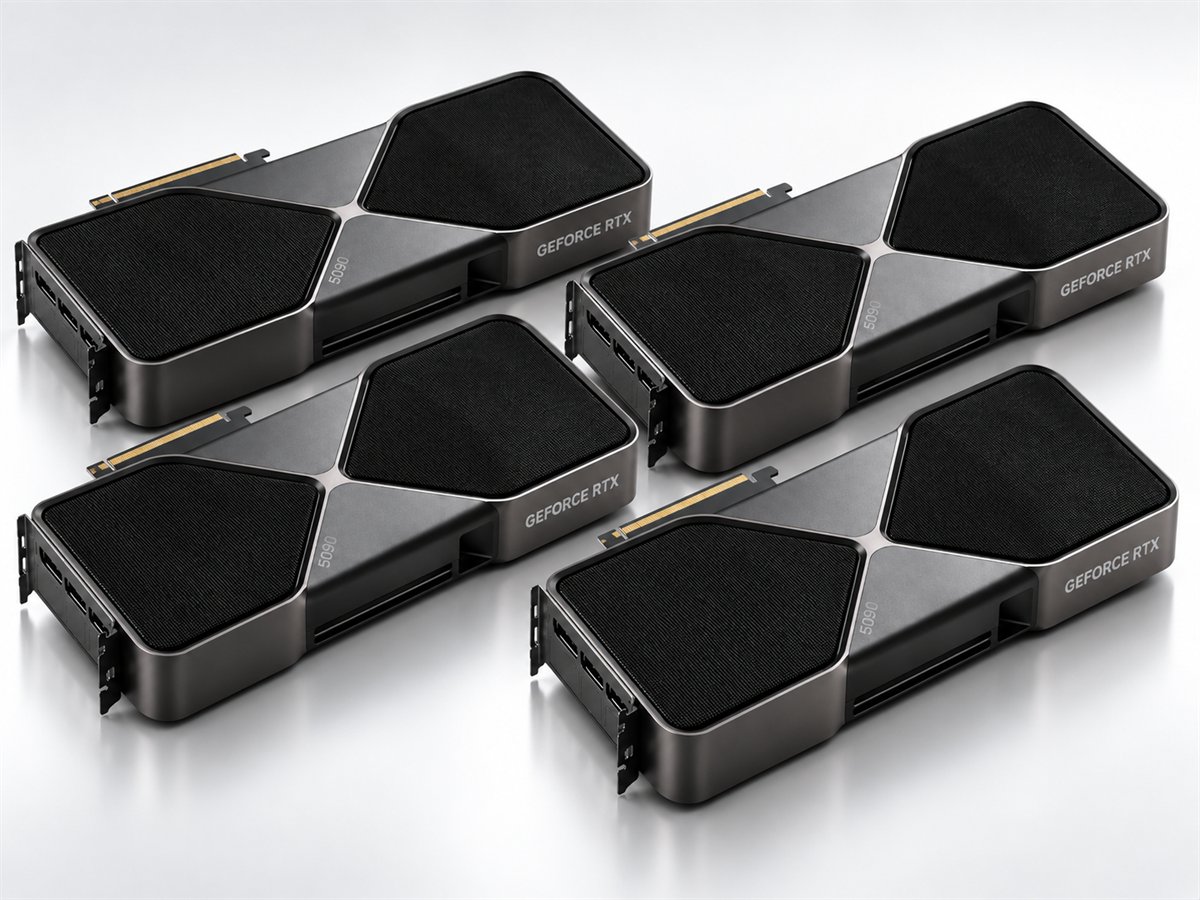
125 GiB 级 MoE 大模型,四张消费级卡跑起来。以下数据来自对应测试环境,用于展示这套配置的真实性能边界与适用条件。
靠 Expert Parallel(专家并行):512 个专家分散到 4 张卡上,每张卡只背 19.86 GiB 权重,而不是 23.61 GiB —— 省下的显存全部变成 KV 池,扩大 63%。
| 单卡账面 | 数值 | 说明 |
|---|---|---|
| 权重 + 非 Torch 开销 | 24.36 GiB | 专家并行后单卡权重降到 19.86 GiB |
| 峰值激活 | 2.58 GiB | 与批大小相关 |
| CUDA Graph | 0.34 GiB | 用于降低解码调度开销 |
| KV Cache | 1.28 GiB | 缓存区本身很小,池子容量由总预算决定 |
| 单卡实际占用 | 28,343 MiB | 余量充足,长期运行不紧张 |
短问答 0.17 秒出第一个字,单路接近 90 tok/s —— 比人阅读快得多。开启投机解码后单路最高 143.69 tok/s。
| 配置 | 单路速度 tok/s | 首 token | 25 万字 + 6K 输出:首 token / 生成速度 / TPOT |
|---|---|---|---|
| 生产推荐(不投机解码) | 88.50 | 0.170 s | 113.33 s / 93 tok/s / 10.73 ms |
| 开启 MTP=1 | 124.61 | 0.135 s | — |
| 开启 MTP=2 | 143.69 | 0.142 s | — |
| 当前生产(EP + MTP=3) | — | 59.85 s | 59.85 s / 217.8 tok/s / 4.58 ms |
实测 20 路并发全部成功、无排队、无 OOM,总吞吐 605 tok/s 时每路仍有 29 tok/s。真实业务里 20 个人同时用,每个人的首字延迟 P95 只有 0.548 秒。
| 并发人数 | 总吞吐 tok/s | 每人速度 tok/s | 首 token P50 | 首 token P95 |
|---|---|---|---|---|
| 1 | 90.50 | 90.50 | 0.170 s | 0.170 s |
| 5 | 288.13 | 57.63 | 0.447 s | 0.454 s |
| 10 | 477.67 | 47.77 | 0.443 s | 0.462 s |
| 15 | 603.68 | 40.25 | 0.448 s | 0.484 s |
| 20 | 580.95 | 29.05 | 0.523 s | 0.548 s |
| 真实 20 并发(20 个不同请求) | 实测 |
|---|---|
| 成功 / 总数 | 20 / 20 |
| 整体耗时 | 16.493 s |
| 总输出 / 总吞吐 | 7,008 tokens / 424.92 tok/s |
| 每人平均速度 | 21.25 tok/s |
| 首 token P50 / P95 | 0.527 s / 0.676 s |
| 完成时间 P50 / P95 | 13.743 s / 16.489 s |
| 排队 / 失败 / OOM | 无 / 0 / 0 |
根据你的模型、并发与业务场景,获取对应的算力部署建议。
在相同硬件条件下,对比其他已完成实测的模型。