模型共性规格
- 规模
- MoE · 512 专家(每次激活 10 个)
- 上下文
- 262,144 tokens 原生支持
- 结构
- 48 层 = 12 层全注意力 + 36 层线性注意力
已完成 NVFP4、UD-Q4_K_XL GGUF 多条量化 / 部署路线实测。已在 3 档硬件配置上完成实测,可直接选择机型查看对应结果。
我们的建议先确定上下文和并发目标,再从下方已实测机型中选择。
通过真实应用案例,直观了解 Qwen3.8-Flash-Next 在实际场景中的表现。
以下配置均已完成该模型实测;选择后进入对应机型下的完整模型实测页。
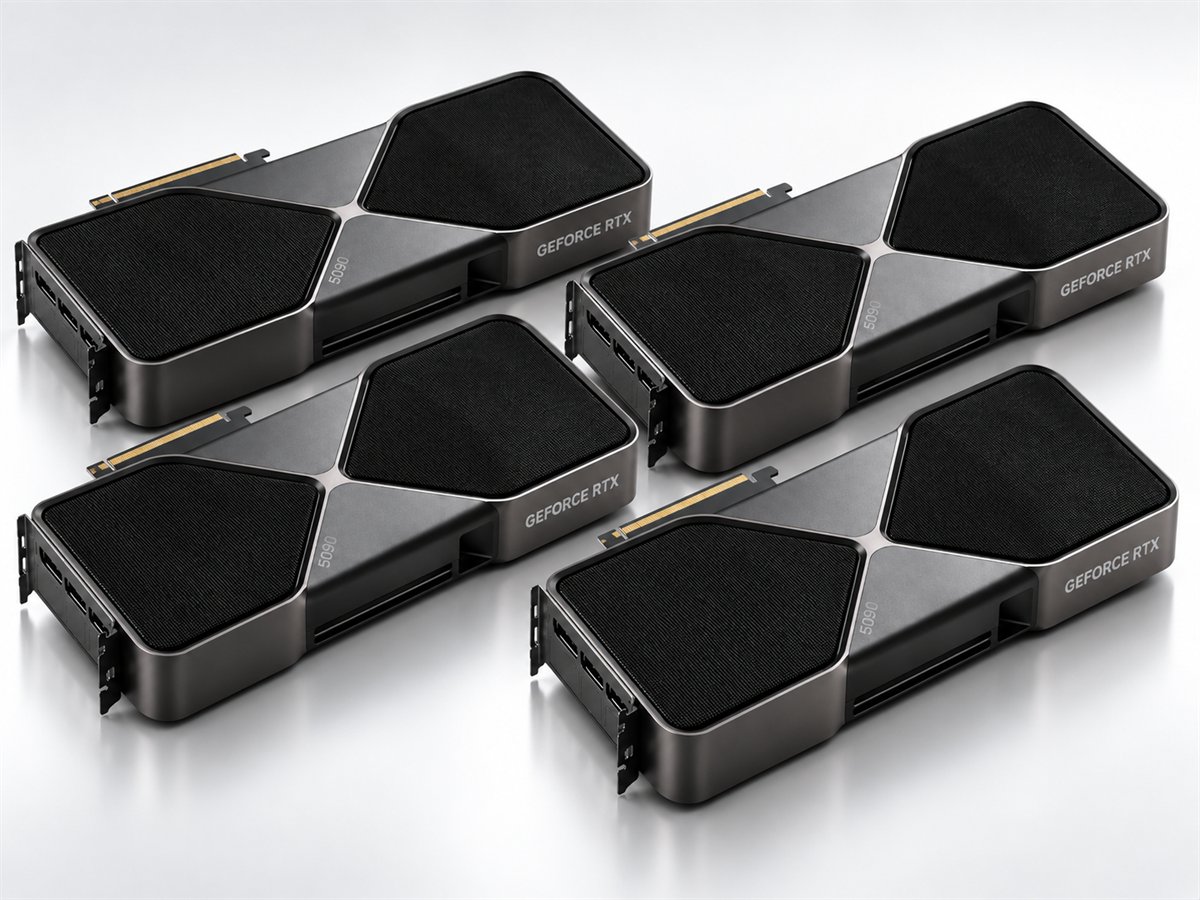
NVFP4 · 主力档:125 GiB 大模型 + 20 人同时在线
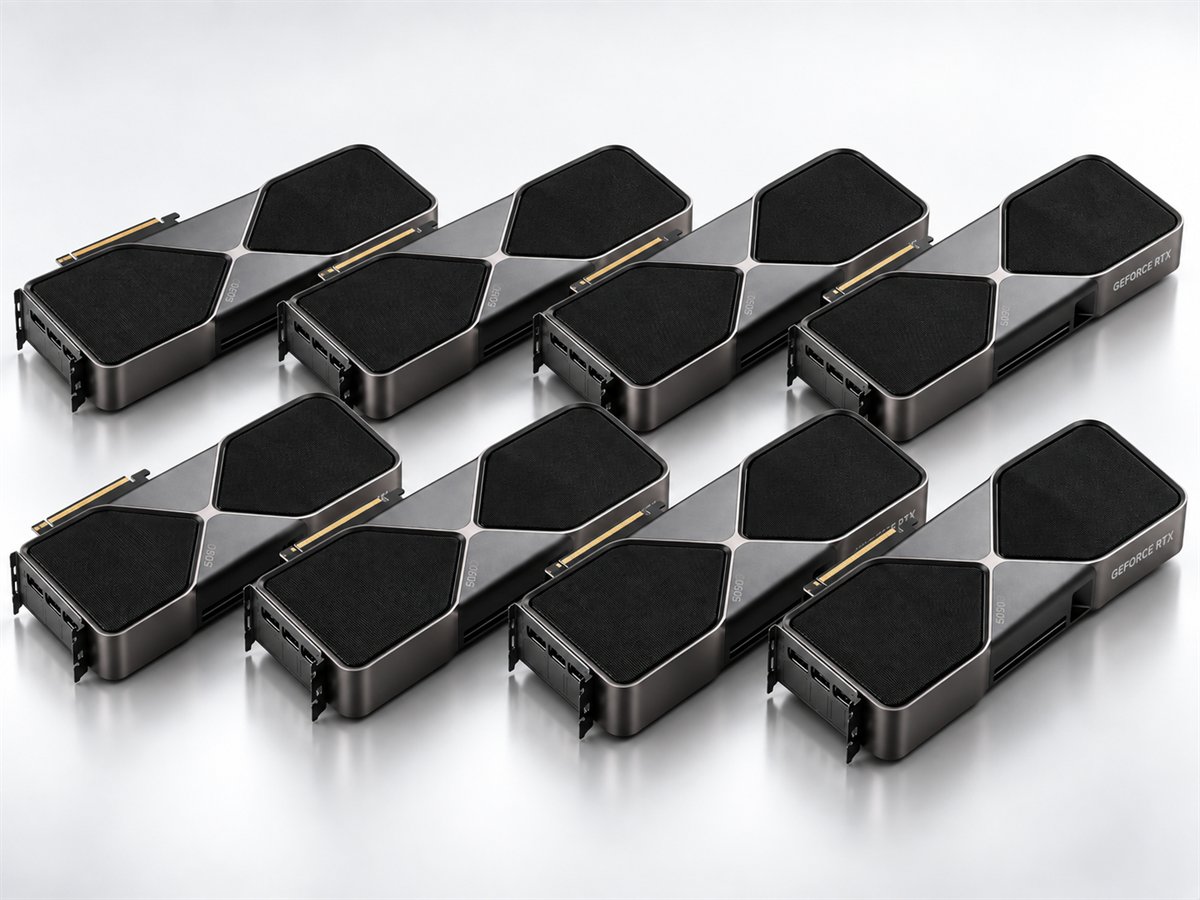
NVFP4 · 高并发档:6 万字上下文,120 人同时在线
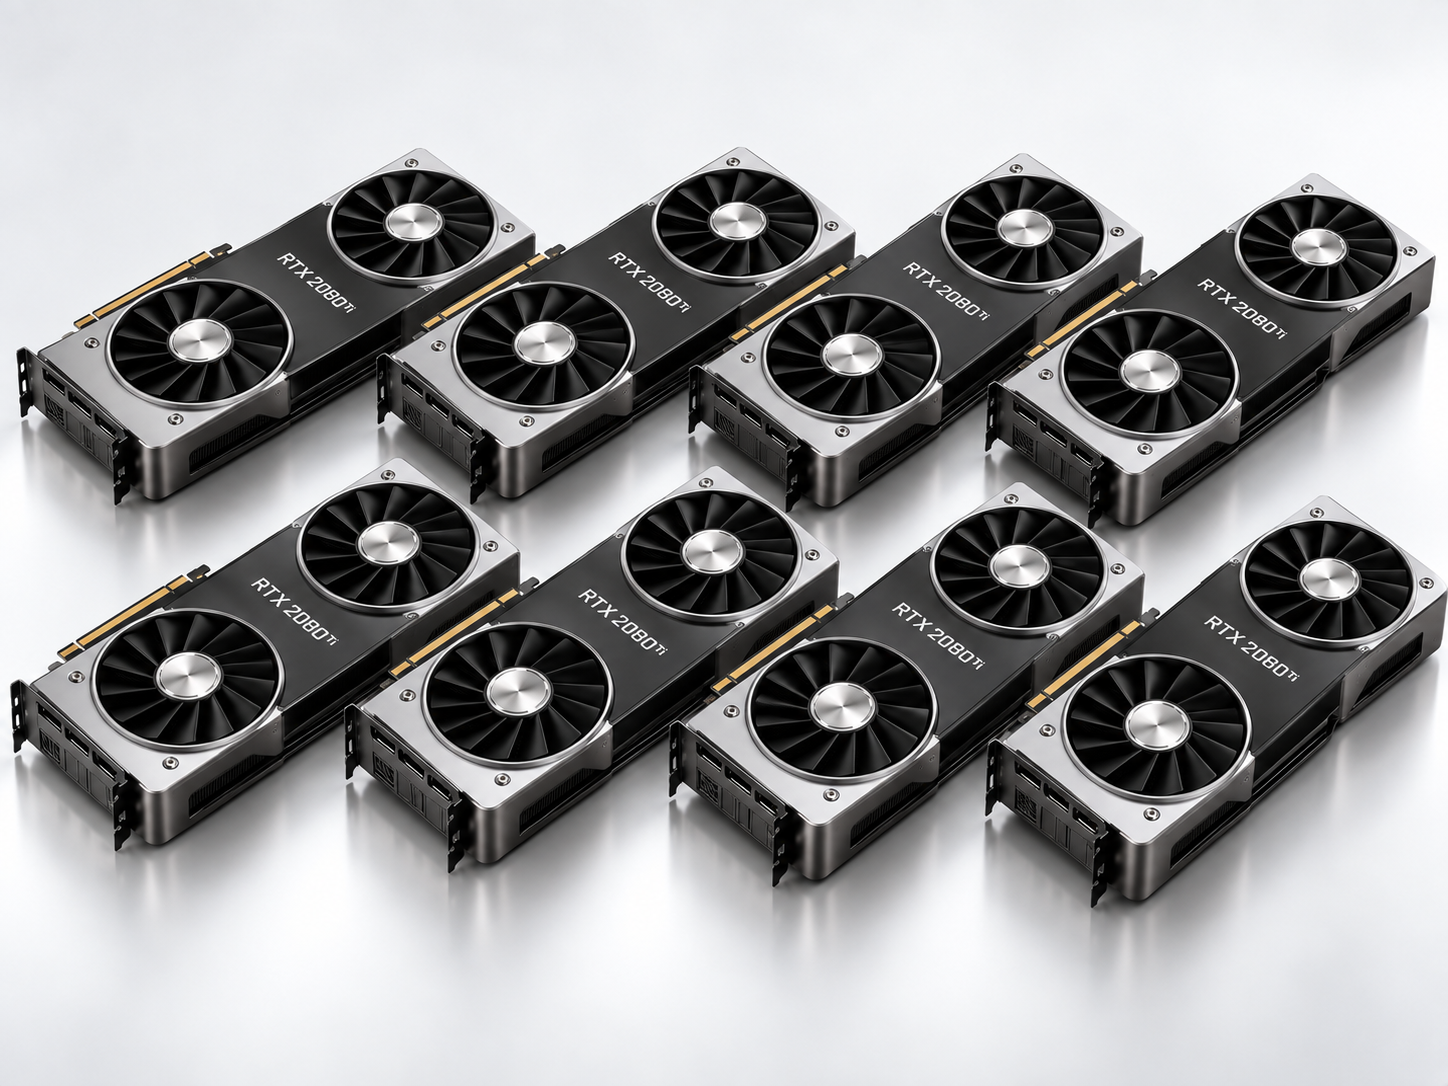
UD-Q4_K_XL GGUF · 存量老卡复用:Flash-Next Q4 稳定 37 tok/s,128K 上下文
使用各机型已有实测指标进行横向整理。
| 配置 | 量化 / 变体 | 总显存 | 关键实测 | 上下文 | 推荐场景 |
|---|---|---|---|---|---|
| 4× RTX 5090 32GB | NVFP4 | 128 GB | 4,474 tok/s 聚合输入吞吐 | 262,144 tokens 原生支持 | 多人在线推理服务 |
| 8× RTX 5090 32GB | NVFP4 | 256 GB | 8,957 tok/s 聚合输入吞吐 | 262,144 tokens | 大规模多人在线服务 |
| 8× RTX 2080 Ti 22GB | UD-Q4_K_XL GGUF | 176 GB | 37.04 tok/s 稳定 Decode | 131,072 tokens(128K) | 存量 2080 Ti 算力复用 |
根据不同业务需求快速选择。